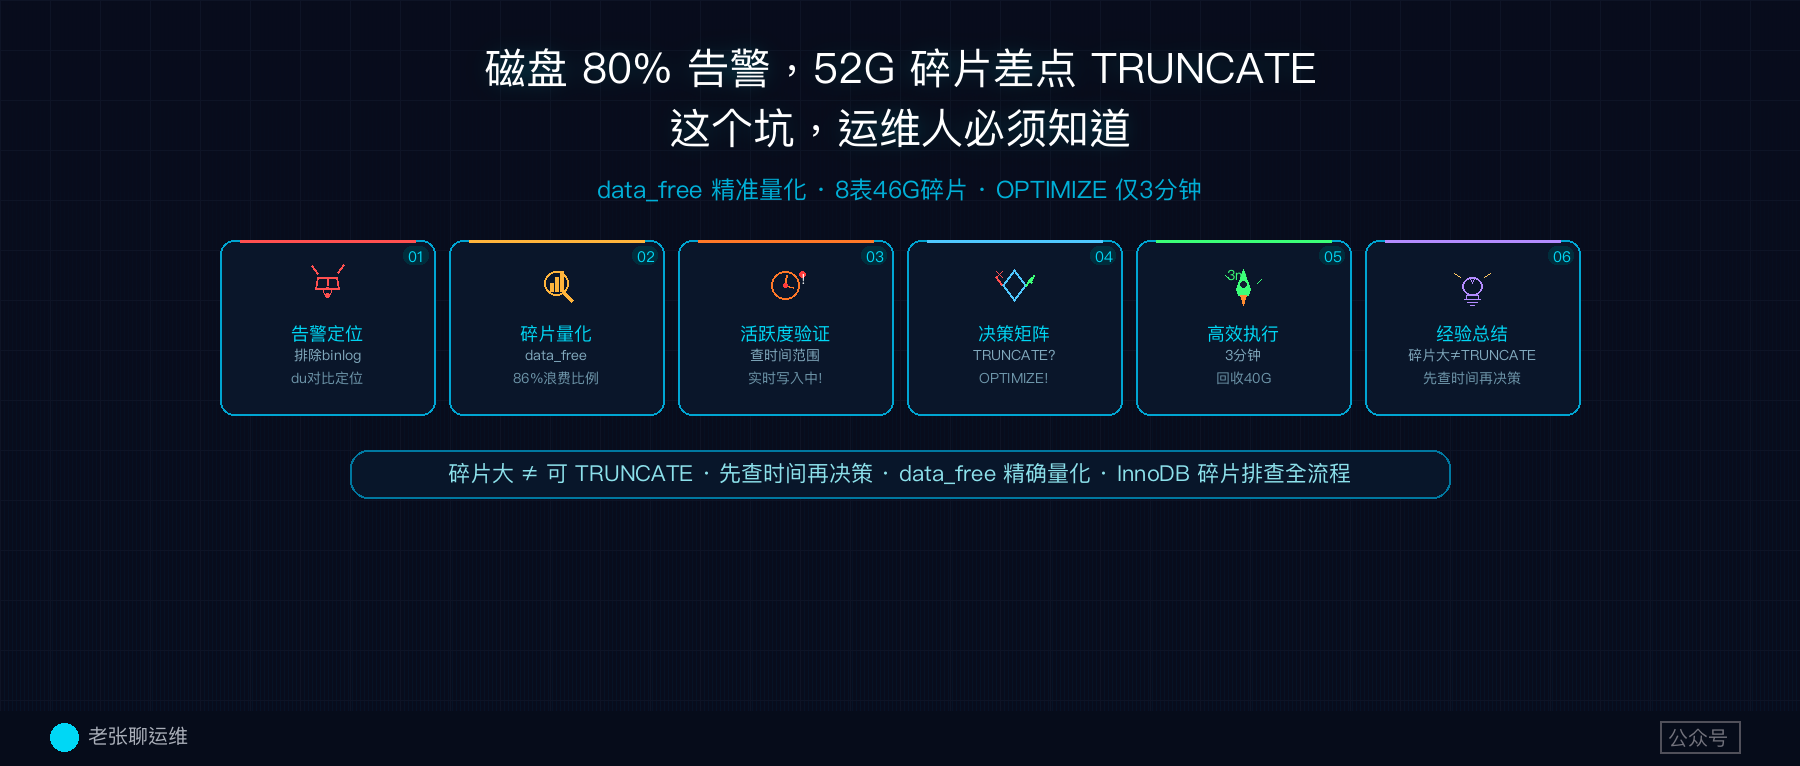
MySQL 磁盘 80% 告警,碎片 52G,我差点 TRUNCATE 掉正在写入的业务表
大家好,我是老张。
连着写了三天博客安全系列,今天换个话题——生产踩坑。
上周写个人博客后台写嗨了,差点在生产环境捅个大篓子。
⚠️ 声明:本文基于真实生产环境排查案例编写,已对 IP 地址、实例名、库名/表名、密码等敏感信息做脱敏处理,命令可直接复制执行。
"磁盘 80% 告警,碎片 52G,TRUNCATE 一下不就完了?"
我相信绝大多数运维人的第一反应都是这个。说实话,我当时也这么想的。
直到我多做了一个操作——查了一下数据的最晚写入时间。
然后冷汗都下来了。
📊 告警来了
某天下午,监控弹出一条告警:Meta MySQL 磁盘使用率超过 80%。
进云平台控制台一看,实例规格 4C16G,磁盘 150GB 本地 SSD,用了 120G。主节点 80.07%,备节点 79.72%,同步正常。
先看磁盘分拆:数据 119.6G + Binlog 509M + 日志 5M。
Binlog 才 500M——不是 Binlog 堆积,数据文件有问题。
🔍 排查:差额到底在哪?
SSH 到管理节点,进 Pod 直连 MySQL:
# SSH 到管理节点
ssh <管理节点IP>

# 进 Pod 直连 MySQL
kubectl exec -it <pod名> -n <namespace> -- mysql -uroot -p
先 SQL 统计各库大小:
SELECT table_schema AS '库名',
       ROUND(SUM(data_length + index_length) / 1024/1024/1024, 2) AS 'SQL统计(GB)'
FROM information_schema.tables
WHERE table_schema NOT IN ('mysql','information_schema','performance_schema','sys')
GROUP BY table_schema ORDER BY 2 DESC;
| 库 | SQL 统计 |
|---|---|
| 库A | 16.8G |
| 库B | 8.3G |
| 库C | 5.1G |
| 库D | 5.1G |
所有库加起来才 ~44G。但磁盘用了 120G——差了 76G。
再用磁盘实际占用对比 SQL 统计,定位差额:
# 进 Pod 的 mysql 容器,直接 du 各库目录
kubectl exec -it <pod名> -n <namespace> -c mysql -- bash -c \
  "du -sh /var/lib/mysql/*/ 2>/dev/null | sort -rh | head -10"
| 库目录 | 磁盘实际 | SQL 统计 | 碎片 |
|---|---|---|---|
| 库B | 60G | 8.3G | 51.7G 🔴 |
| 库A | 23G | 16.8G | 6.2G |
| 库C | 7.6G | 5.1G | 2.5G |
| 库D | 6.8G | 5.1G | 1.7G |
一个库吃掉了 52G 碎片。
精确量化:data_free 排名
要找碎片最大的表,最快的方式是看各表的 .ibd 文件实际大小,再跟 SQL 统计对比:
# 进 Pod,查目标库下所有 .ibd 文件大小
kubectl exec -it <pod名> -n <namespace> -c mysql -- bash -c \
  "du -sh /var/lib/mysql/<库名>/*.ibd 2>/dev/null | sort -rh | head -15"
结果跟 du 数据吻合——8 张表的 .ibd 文件远大于 SQL 统计值。下一步用 data_free 精确量化。
DBA 要求用 information_schema.TABLES 的 data_free 字段——这个字段统计的是 InnoDB 内部已分配但未使用的空间,比 du 更准确:
SELECT
  CONCAT(table_schema, '.', table_name) table_name,
  ROUND((data_length + index_length) / 1024/1024, 2) AS '数据大小(M)',
  ROUND(data_free / 1024/1024, 2) AS '碎片(M)',
  (100*(data_free/(data_length+index_length+data_free))) AS '浪费比例%'
FROM information_schema.TABLES
WHERE table_schema NOT IN ('mysql','information_schema','performance_schema','sys')
ORDER BY data_free DESC LIMIT 8;
结果触目惊心:
| 表 | 实际数据 | 碎片 | 总占用 | 浪费比例 |
|---|---|---|---|---|
| 表1 | 1.4G | 9.2G | 10.6G | 86.3% |
| 表2 | 666M | 7.6G | 8.3G | 92.0% |
| 表3 | 152M | 6.6G | 6.8G | 97.8% |
| 表4 | 1.1G | 5.2G | 6.4G | 81.7% |
| 表5 | 103M | 4.3G | 4.4G | 97.7% |
| 表6 | 69M | 4.0G | 4.1G | 98.3% |
| 表7 | 83M | 3.2G | 3.3G | 97.5% |
| 表8 | 2.6G | 1.9G | 4.6G | 41.0% |
8 张表合计碎片约 46G,大部分浪费比例 80%+。其中表 3 最夸张——实际数据只有 152M,碎片却有 6.6G,浪费 97.8%。
看到这个数据,我脑子里的第一反应不是"这表还在用吗?"——而是"这表居然能有这么多碎片?"
98% 的浪费率,大脑会直接下结论:这是张废弃表,没人管了。
更何况,业务方上周刚跟我说过"库B那几张历史表没用了,有空清一下"。
到这一步,直觉告诉我:TRUNCATE 掉就完事了。
⚠️ 转折:多做了一个操作
正准备提单 TRUNCATE,突然想到一个问题——这表还在用吗?
先看表结构,找时间字段:
SHOW FULL COLUMNS FROM 库B.表1;
常见时间字段叫 created_time、gmt_create、create_time,找到后查数据时间范围:
SELECT
  MIN(created_time) AS 最早创建,
  MAX(created_time) AS 最晚创建,
  COUNT(*) AS 总行数
FROM 库B.表1;
结果:
最早创建: 2026-07-25 23:15:02
最晚创建: 2026-08-04 11:00:31 ← 就是现在!
总行数: 202,257
最晚创建时间就是查询时刻——这张表是活的,实时高频率写入中。20 万行记录仅 10 天数据,9.2G 碎片来自频繁 INSERT/UPDATE/DELETE,InnoDB 来不及回收。
如果刚才直接 TRUNCATE,几 万行业务数据就没了。
😱 冷汗都下来了。
💡 决策矩阵
面对碎片表,判断能不能 TRUNCATE 的关键不是碎片大小,而是数据时间范围:
| 时间特征 | 判断 | 方案 |
|---|---|---|
| 最早 > 6 个月前,最晚也是 6 个月前 | 冷数据 | TRUNCATE(确认业务已停) |
| 最早 < 1 个月前,最晚 = 此刻 | 活跃写入 | OPTIMIZE,不能 TRUNCATE |
| 时间跨度短 + 行数多 | 高频写入碎片 | 低峰期 OPTIMIZE |
🛠️ OPTIMIZE 执行:比预估快 20 倍
方案确定:逐表 OPTIMIZE TABLE,变更窗口定在下午 6 点。
-- 逐表执行,每张跑完再跑下一张
OPTIMIZE TABLE 库B.表1;
OPTIMIZE TABLE 库B.表2;
OPTIMIZE TABLE 库B.表3;
OPTIMIZE TABLE 库B.表4;
OPTIMIZE TABLE 库B.表5;
OPTIMIZE TABLE 库B.表6;
OPTIMIZE TABLE 库B.表7;
OPTIMIZE TABLE 库B.表8;
预估:表 1 有 10.6G 总占用,按经验得跑十几分钟。8 张表下来至少 1 小时。
实际执行:
| # | 表 | 碎片 | 实际耗时 | 结果 |
|---|---|---|---|---|
| 1 | 表8 | 1.9G | 1m39s | ✅ |
| 2 | 表7 | 3.2G | 0.6s | ✅ |
| 3 | 表6 | 4.0G | 2.9s | ✅ |
| 4 | 表5 | 4.3G | 3.4s | ✅ |
| 5 | 表4 | 5.2G | 6.4s | ✅ |
| 6 | 表3 | 6.6G | 5.3s | ✅ |
| 7 | 表2 | 7.6G | 15.6s | ✅ |
| 8 | 表1 | 9.2G | 9.7s | ✅ |
| 合计 | ~46G | ~3 分钟 |
8 张表跑完,总共不到 3 分钟。
为什么这么快?因为表虽然总占用 8-10G,但 86-98% 是碎片。OPTIMIZE 只拷贝有效数据——10G 的表实际数据只有 1.4G,搬这点东西当然快。
🎉 最终效果
磁盘使用率:80% → 53%,回收约 40G。
| 节点 | 磁盘 | 数据 | Binlog | 同步 |
|---|---|---|---|---|
| 主 | 52.93% | 78.8G | 583M | 0ms |
| 备 | 52.92% | 78.7G | 560M | 1s |
❓ 读者可能会问:碎片这么大了为什么不清?
很简单:之前没人知道。
- 业务方:表还在正常写入,不知道有碎片问题
- 开发:只管用业务逻辑,不会定期查
data_free - DBA:管几百个实例,顾不上这种"还没爆雷"的碎片
- 运维:只看磁盘使用率,80% 告警才拉群
这就是运维的日常——问题不到炸出来的那一刻,没人会主动关注。
如果今天不是我多查了一步 MAX(created_time),这张表就没了。
💡 老张的经验总结
✅ 做对了什么
- 先排除 Binlog——控制台分拆一看 500M,直接跳过不必要的排查
- du vs SQL 双对比——磁盘 60G、SQL 8G,差额就是碎片,定位精准
- data_free 精确量化——比 du 估算更准,而且是 DBA 认可的标准指标
- 数据活跃度验证——这是整个排查中最关键的一步。碎片再大也不能无脑 TRUNCATE
- OPTIMIZE 比预估快——碎片率越高跑得越快,因为只搬有效数据
⚠️ 如果再遇到这种事
- 先查时间范围,再做决策——不管你多确定这表没用了,不管业务方跟你说过多少次"这表可以清",跑一条
SELECT MIN/MAX只要 0.1 秒。别人说的"没用",跟数据库里的"真没用",中间隔了 几万行数据。 - 定时统计 data_free——可以加到巡检脚本里,碎片率 > 50% 就告警,别等 80% 了再处理
- 碎片率越高的表,OPTIMIZE 越快——这个反直觉的事实,记下来
- "业务方说没用"不算数,"最后一条写入是半年前"才算数——口头承诺不可信,数据库里的时间戳才是铁证
🔧 碎片排查命令速查
-- 1. 查看各库碎片 Top
SELECT
  table_schema AS '库',
  ROUND(SUM(data_free) / 1024/1024/1024, 2) AS '碎片(GB)'
FROM information_schema.TABLES
WHERE table_schema NOT IN ('mysql','information_schema','performance_schema','sys')
GROUP BY table_schema ORDER BY 2 DESC;

-- 2. 查看某库表碎片排名(含浪费比例)
SELECT
  table_name AS '表名',
  ROUND((data_length + index_length) / 1024/1024, 2) AS '数据(M)',
  ROUND(data_free / 1024/1024, 2) AS '碎片(M)',
  ROUND(100 * data_free / (data_length + index_length + data_free), 1) AS '浪费%'
FROM information_schema.TABLES
WHERE table_schema = '你的库名'
ORDER BY data_free DESC LIMIT 10;

-- 3. ⚠️ 关键:查数据时间范围(决定能不能 TRUNCATE)
SELECT MIN(created_time), MAX(created_time), COUNT(*) FROM 你的库.你的表;

-- 4. OPTIMIZE(低峰期执行)
OPTIMIZE TABLE 你的库.你的表;
🎯 适合谁看?
| 场景 | 推荐程度 |
|---|---|
| MySQL 磁盘告警不知道怎么排查 | ⭐⭐⭐⭐⭐ |
| 遇到过碎片但不确定 TRUNCATE 还是 OPTIMIZE | ⭐⭐⭐⭐⭐ |
| 想知道 data_free 怎么用 | ⭐⭐⭐⭐ |
| 纯开发不碰数据库运维 | ⭐⭐ |
💬 聊聊你的经历
- 你遇到过 MySQL 碎片占磁盘一半以上的情况吗?
- TRUNCATE 和 OPTIMIZE 之间你一般怎么选?有没有踩过坑?
- 你们会在巡检里加 data_free 监控吗?