MiniMax M3.1公测:给娃做的英语APP,几百条音频全是它配的音
一句话结论:MiniMax 今天(9 月 28 日)上线 M3.1-Flash-Preview 公测——百万上下文、原生多模态、主打编程,9.28 到 10.7 还有签到领双倍积分的活动;趁这个由头,老张把自家英语启蒙里几百条音频全靠 MiniMax 生成的实战经验,一次性倒出来。
事情的起因是给自家娃做英语启蒙。
市面上的启蒙 APP 大多是「孩子独自看屏幕」,家长靠边站。老张想要的是亲子共玩:屏幕出题、发音、记记录,家长当老师、孩子当玩家。于是有了 Magic Words(魔法单词) 这个项目——纯自建,内容自控。
整个项目里,所有英文发音——单词、字母带读、亲子剧本台词、鼓励语——没有一条是人录的,全部是 MiniMax 的 TTS 接口批量生成的。M3.1 发布这天,正好把这套路子完整讲一遍。
先说新闻:M3.1-Flash-Preview 是什么
| 项目 | 内容 |
|---|---|
| 模型 | MiniMax-M3.1-Flash-Preview |
| 上线 | 9 月 28 日,开启公测 |
| 架构 | MoE,百万级上下文窗口,原生多模态 |
| 主打 | 编程 / 日常开发:从 Bug 修复到完整功能开发 |
| 开放方式 | 暂时只走 Token Plan 和 MiniMax Code,未开放独立 API 付费调用 |
| 福利 | 9.28 – 10.7 在 MiniMax Code 签到领双倍积分;上线有赠送额度卡 |
两句大实话。
一,这是语言模型,不是语音模型——它不负责配音,负责写代码、跑 Agent。想让 M3.1 给你读单词的,先等等。
二,公测阶段没有独立 API 定价,消耗的是 Token Plan / MiniMax Code 的积分额度。活动细节官方口径还在更新,以开放平台活动页实际为准。
再说实战:音频流水线怎么搭
先看成品。字母狩猎游戏里,娃找到字母 A,弹出的卡片点「再听一遍」,播放的就是 MiniMax 生成的音频:
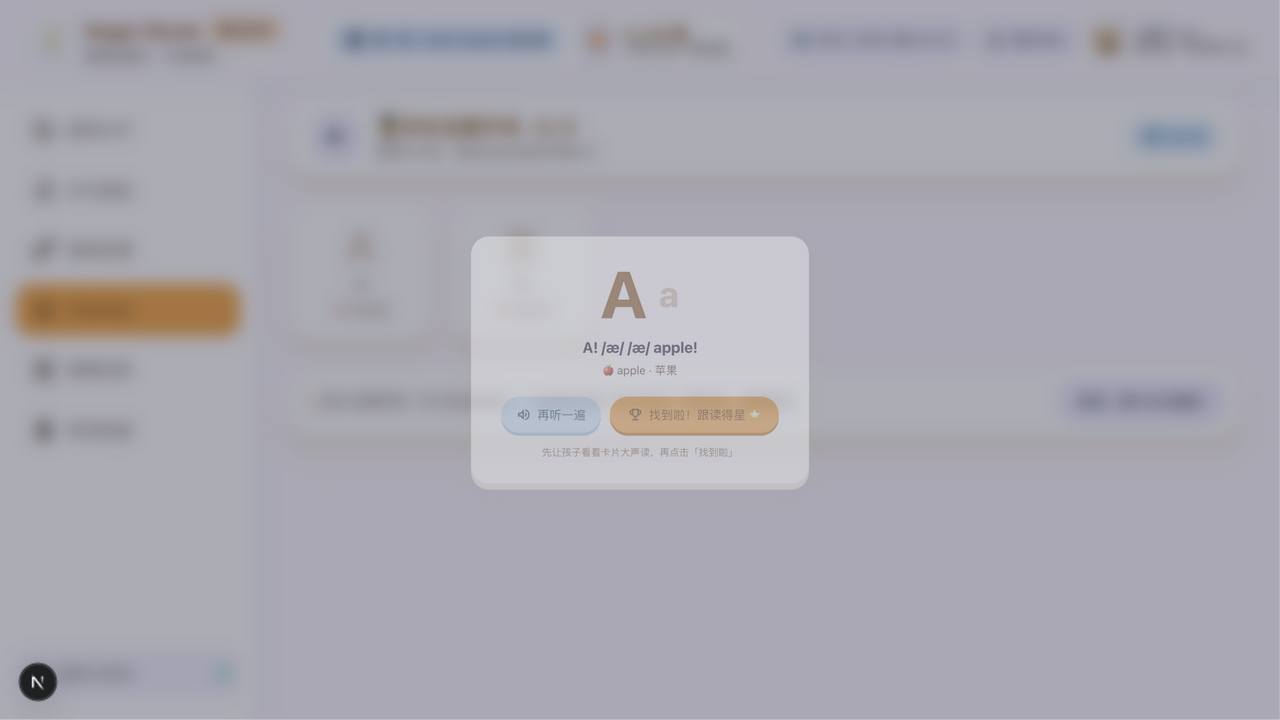
A! /æ/ /æ/ apple!——这句正是流水线里自动拼出来的字母带读文案。
整个链路五步:
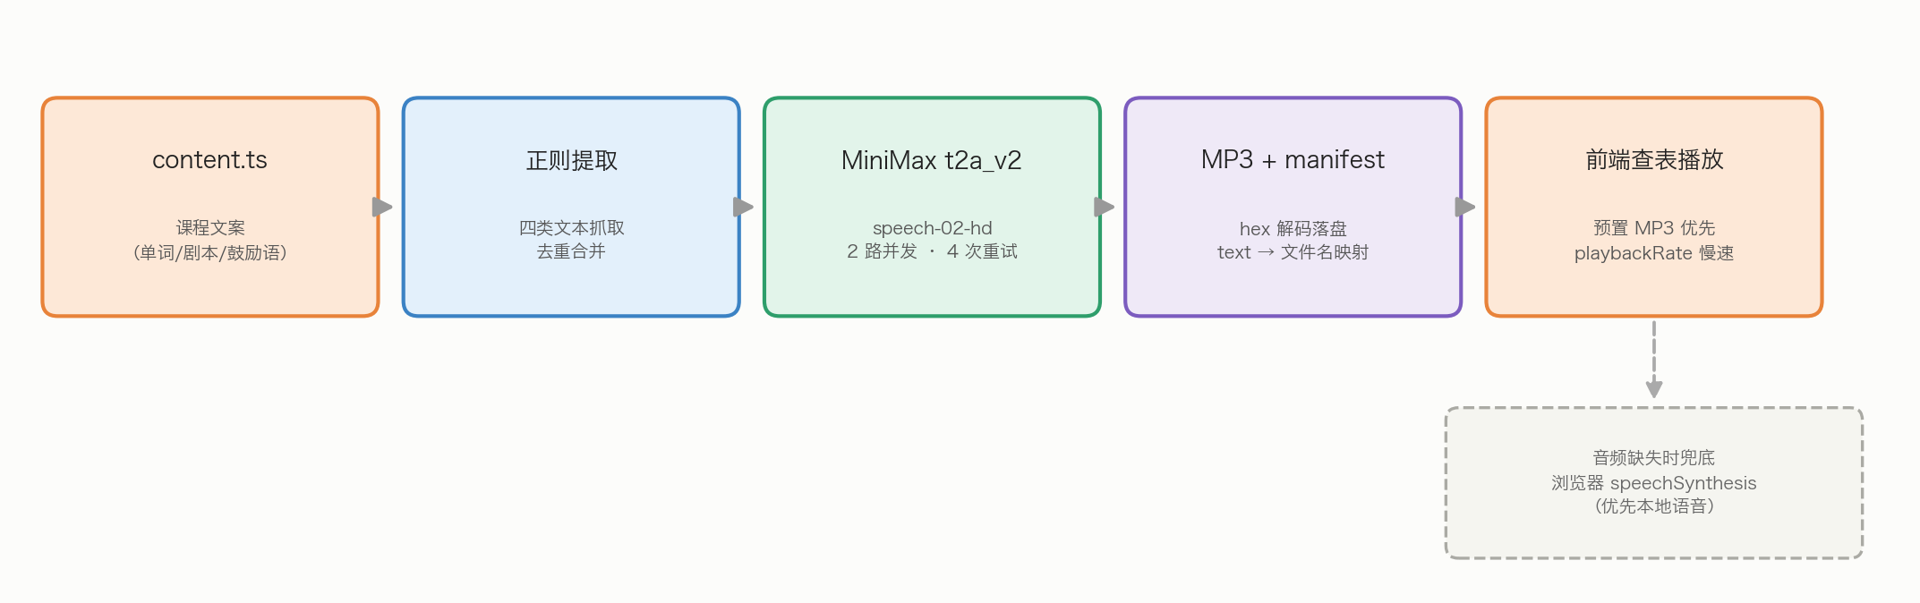
核心是一个两百来行的 Python 脚本(generate_audio.py):
- 正则提取:从
content.ts里把所有要朗读的文本抓出来——单词、字母锚词、剧本台词、鼓励语,四类来源,一个 dict 去重; - 批量生成:调 MiniMax
t2a_v2接口,模型speech-02-hd,2 路并发; - 落盘:返回的音频是 hex 编码,
bytes.fromhex解码直接写 MP3,按文本 slug 命名存进public/audio/; - 生成 manifest:文本 → 文件名的映射,同时写出
.ts和.json两份; - 前端查表播放:预置 MP3 优先,找不到文件再兜底。
这结构最爽的一点:改文案只管改 content.ts,跑一遍脚本,音频自动跟上。内容生产 和 音频生产 完全解耦。
关键配置(可直接抄)
body = {
    "model": "speech-02-hd",
    "text": text,
    "voice_setting": {"voice_id": "English_Gentle-voiced_man",
                      "speed": 1, "vol": 1, "pitch": 0},
    "audio_setting": {"sample_rate": 32000, "bitrate": 128000,
                      "format": "mp3", "channel": 1},
    "language_boost": "English",
}
音色是分角色的:单词/字母/剧本用 English_Gentle-voiced_man(温和男声,听久了不腻);鼓励语用 Cute_Elf,还加了 emotion: "happy"——一句 "Great job!" 要是念得跟播新闻似的,娃哪还有劲头。
踩过的三个坑
坑一:字母读音,模型没错,是文本的错。
单个字母 "G" 直接喂进去,读出来的音不对。怎么调参都没用。最后在脚本里加了个 TEXT_OVERRIDES 补丁表,把生成文本从 G! g, g, grapes! 改写成 Gee! g, g, grapes!,一次过。另一个例子更典型:连读的 "w, w" 用温和男声会糊成一片,解决办法是换句子 + 换音色双管齐下。
TTS 的坑,八成不在模型,在喂给它的文本上。
妙的是 manifest 的 key 保持原文不变,只换生成侧的文本——前端代码一行不用动。
坑二:并发、重试、hex,工程三件套。
接口偶发超时是常态。脚本里 4 次重试、8 秒递增退避、2 路并发封顶——贪多并发只会收获一屏幕 429。返回的 data.audio 是 hex 字符串,忘了解码写出来的 MP3 双击打不开,别问是怎么知道的。
坑三:浏览器兜底,国内网络有暗坑。
预置 MP3 万一缺失,前端降级到浏览器 speechSynthesis。这里有个隐蔽问题:Google 的在线语音在国内网络下会静默失败,不报错,就是没声音。所以选声源时优先 localService 的本地语音。另外两个小技巧:慢速磨耳朵用 playbackRate 降速(音调不变,不会变低音炮);儿童向发音把 pitch 提到 1.12。
模型负责像人,工程负责不翻车。
M3.1 跟这个项目有关系吗
直接关系:没有。配音这条线,M3.1 插不上手,项目里的 speech-02-hd 继续服役。真要升级,值得盯的是语音线的 Speech-2.8——官方说法是自然语气词、更通透的音质,哪天闲了跑个 A/B 对比再汇报。
间接关系:很大。Magic Words 的课程内容(52 周地图、单词、剧本)全是手工维护的文本,这类活正是 M3.1 主打的编程/Agent 场景能接管的方向。双倍积分窗口 9.28 – 10.7,共 10 天,薅一把不亏。
🎯 老张建议
- 要薅趁早:MiniMax Code 签到双倍积分到 10 月 7 日截止,M3.1-Flash-Preview 公测期间走积分额度,不另计 API 费。
- TTS 项目直接抄作业:文案与音频解耦 + manifest 查表 + 浏览器兜底,这套结构几百条音频也稳;
language_boost记得开,英文发音差异明显。 - 发音不对先改文本再调参:把「读不准的词」换写法,比换模型换音色便宜得多。
💬 互动话题
- 你家娃的英语启蒙用什么工具?屏幕时间怎么控制的?
- 项目里的 TTS 你选哪家?MiniMax、Azure 还是 Edge-TTS 白嫖流?
- M3.1 的编程能力你在公测里试了吗,跟 M3 比感知明显吗?
🔗 关注老张
公众号:老张聊运维 小程序:观简国学 个人博客:https://www.shanwaiyun.top/