GLM-5.3-FlashX上线:每秒200 tokens,和GLM-5.3-Flash怎么选
一句话结论:智谱把"牛"提速了——GLM-5.3-FlashX 正式上线,最高每秒吐 200 tokens,API 已开放;GLM-5.3-Flash 原样保留,继续守智能和价格基本盘。
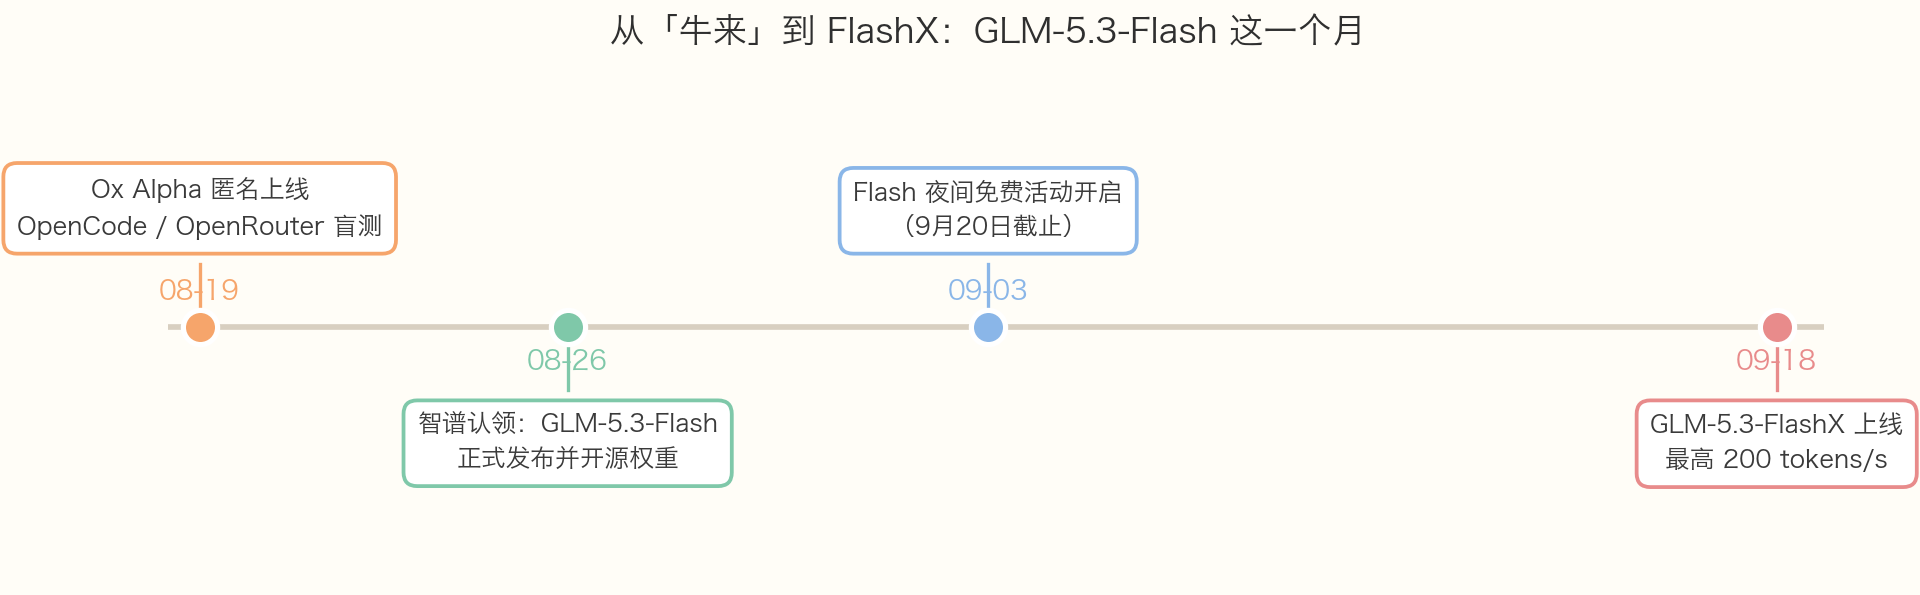
8 月底,它还顶着 "Ox Alpha" 的马甲在 OpenCode 和 OpenRouter 上匿名接单,盲测冲上当周最受欢迎的模型。9 月 18 日,智谱给这头牛加了个涡轮。
先上速览:
| 项目 | 内容 |
|---|---|
| 上线模型 | GLM-5.3-FlashX(glm-5.3-flashx) |
| 核心升级 | 最高 200 tokens/s |
| 算力底座 | 10 万张国产芯片推理集群 |
| GLM-5.3-Flash | 保留,智能、价格不变 |
| 使用方式 | API、BigModel 体验中心已开放 |
发生了什么
智谱官方公众号今天发文,原话挺直白:Flash 的调用量一直涨,为了扛住增长,在 10 万张国产芯片的推理算力之上,继续加码 Infra 投入和推理优化,然后就有了 FlashX。
关键信息三条,都是官方口径:
- 速度:最高 200 tokens/s,主打企业和开发者场景的流畅体验;
- 智能不降档:官方强调 GLM-5.3-Flash 长期保持同尺寸档最强智能水平和极高性价比,这次提速之后,智能、价格、速度三个角都站住了;
- 怎么用:API 的 model key 就是 GLM-5.3-FlashX,文档在 docs.bigmodel.cn,体验中心选上模型就能试。
先补个背景:这头牛是怎么来的
没跟过这条线的读者,一分钟补完。
8 月中下旬,一个代号 Ox Alpha 的匿名模型悄悄挂上 OpenCode 和 OpenRouter。没有官方背书,没有发布会,纯靠开发者盲测接单,结果冲上当周最受欢迎模型。
一周后,8 月 26 日,智谱出来认领:它就是 GLM-5.3-Flash。320B 总参数、18B 激活,GLM-5 系列第一个原生多模态模型,1M 上下文,权重直接开源。中文社区给它起了个外号——"牛来"。
成绩单挑几个硬的:
- Terminal Bench 2.1 拿了 84.3,同表里 Claude Opus 4.8 是 85.0,基本贴脸;
- DeepSWE v1.1 拿了 63.4,上一代 GLM-5.2 只有 46.2,一步跨了 17 分;
- Toolathlon 78.4,官方那张对比表里一排旗舰,它最高;
- 价格是真正的杀招:定价是 GLM-5.3 的 1/10,限时折扣期约 1/20,差不多是 Opus 4.8 的 1/40。
还有个细节,老张作为运维出身必须单独拎出来:官方博客写得明明白白,ox-alpha 时期的全部流量就跑在国产 AI 芯片上。自研的 SGLang 定制推理引擎、W8A8 量化、EPD 分离部署,端到端服务能力提升了 3 倍。
一个模型在大规模国产芯片上稳稳服务了全球开发者一整个盲测周期,这事以前没发生过。
更朋克的是,官方说他们用 GLM-5.3 的 agent 去优化给 Flash 服务的算子——模型在优化给自己推理的机器。这飞轮转起来有点吓人。
Flash 和 FlashX,怎么选
先说结论:**FlashX 不是新模型,是 Flash 的全速档。**智能水平同一档,差别在推理侧。
| GLM-5.3-Flash | GLM-5.3-FlashX | |
|---|---|---|
| API 代号 | glm-5.3-flash | glm-5.3-flashx |
| 官方速度口径 | 未单独标榜 | 最高 200 tokens/s |
| 开源权重 | 有(HuggingFace) | 官方暂未提 |
| Coding Plan | 已覆盖,配额 3 倍于 GLM-5.3 | 截至发稿暂未列入 |
对号入座:
- 跑批处理、离线任务、不在乎延迟——Flash,价格最优解;
- 交互式编码、Agent 高频循环、实时对话——FlashX,一轮任务几十次调用,速度差叠加起来很可观;
- GLM Coding Plan 用户(老张这种)——继续用 Flash,FlashX 暂时不在套餐里,等官方消息;
- 想自己部署——只有 Flash 开了权重,FlashX 目前是官方 API 专属。
价格方面:Flash 刊例输入约 0.8 元、输出约 2.8 元每百万 tokens(GLM-5.3 是 8 元和 28 元)。FlashX 官方推文没单独说定价,以 BigModel 价格页为准。
顺便提醒:Flash 的夜间免费活动到 9 月 20 日,还剩两天窗口,规则以官方页面为准。
老张判断
- 这条新闻真正的看点不是 200 tokens/s 这个数字,是底座——10 万张国产芯片加自研推理栈,扛住了全球开发者一个月的盲测流量。国产算力的叙事,第一次这么具体。
- Flash / FlashX 双轨是标准打法:Flash 守价格心智,FlashX 守体验心智。真正值得等的是 FlashX 什么时候进 Coding Plan——进了,日常编码直接无缝换挡。
- 普通开发者的动作很简单:把 model key 换成 glm-5.3-flashx,跑一遍你手头最真实的任务。体感比跑分诚实。
🎯 老张建议
- 不差延迟的活儿全给 Flash,它就是当前的性价比天花板;
- 对话、编码这类人对着屏幕干的场景,换 FlashX,200 tokens/s 的体感差异很大;
- Flash 开源权重加国产芯片推理方案,做私有化部署的团队值得认真研究一遍。
💬 互动话题
- 你的 Agent 任务里,等模型回话的时间占多少?换 200 tokens/s 能省出多少?
- Coding Plan 什么时候上 FlashX?你猜官方在憋什么?
- 国产芯片跑出这个性价比,你觉得能复制到下一代模型吗?
🔗 关注老张
公众号:老张聊运维 小程序:观简国学 个人博客:https://www.shanwaiyun.top/