智谱 GLM-5.3-Flash:性能对标 Opus 4.8、定价只要十分之一,多平台都在抢它
大家好,我是老张。
最近 AI 圈有个大新闻——智谱 AI 正式发布并开源了 GLM-5.3-Flash。这款模型在发布前以「Ox Alpha」(中文社区叫「牛来」,六天匿名)的身份,悄悄上线了 OpenRouter 和 OpenCode 两个平台。
按智谱官方在技术博客中的原文:
"Ox-Alpha 迅速成为当周最受欢迎的模型,创下双平台调用量新高。而这些请求流量全部由国产芯片提供算力支持。"
老张今天就把官方文档、OpenRouter、人工智能分析机构 Artificial Analysis 的数据全部过一遍,给大家一个靠谱的全景介绍。所有数据都标明出处,不写江湖传闻。
📌 一句话定位
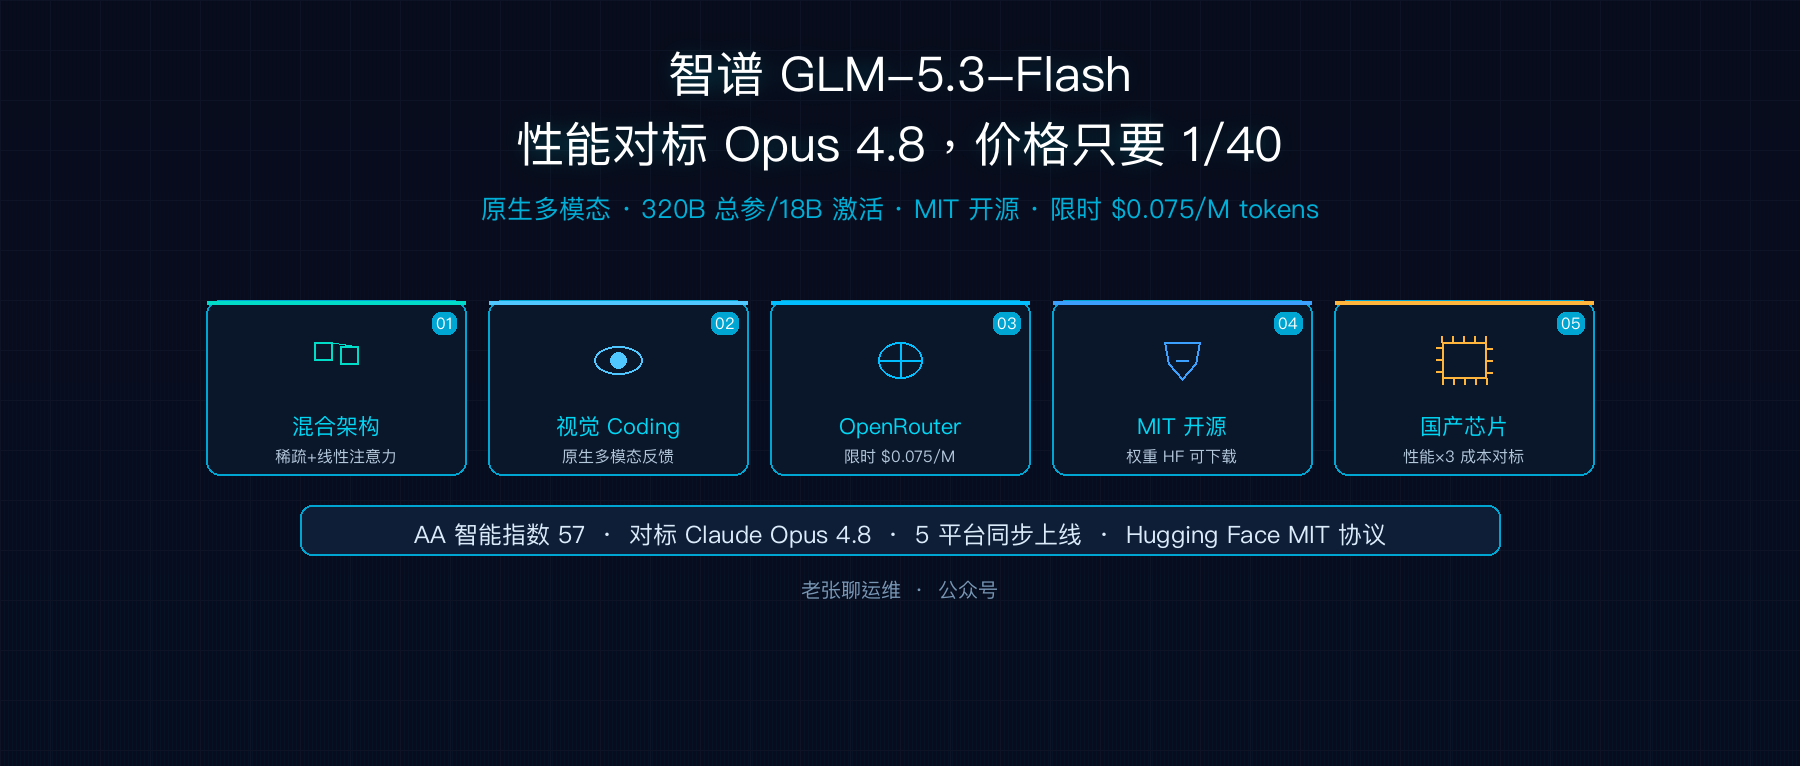
GLM-5.3-Flash 是智谱 GLM-5 系列的第一个原生多模态模型,主打「极致低成本 + 旗舰级智能」——官方说它总参数 320B、激活 18B,架构上首次在 GLM 主系列引入稀疏注意力与线性注意力混合架构,目标是用 Flash 模型的算力成本,做出旗舰模型的智能水平。
官方原话:GLM-5.3-Flash 整体性能超过 GLM-5.2,编程和 Agent 评测已经接近 Claude Opus 4.8,但价格只有 GLM-5.3 的十分之一(限时折扣期内为二十分之一,对标 Claude Opus 4.8 为四十分之一)。 ——智谱 AI 官方技术博客
🚀 三大核心亮点
1️⃣ 极致高效的混合架构
- 总参数量:320B(与 GLM-4.5 的 355B 基本持平)
- 激活参数量:18B(仅为 GLM-5.3 的一半不到)
- 层数:45 层(GLM-5.3 为 92 层,几乎砍半)
- 架构创新:
- 首个开源的稀疏注意力 + 线性注意力混合架构
- 引入 流形约束超连接 mHC(Manifold-Constrained Hyper-Connections)
- 借助 IndexPool 加权池化,把索引器 4 个缓存向量压缩成 1 个
- 效率提升(官方数据):
- 相较 GLM-5.3,注意力计算量降低 3.01 倍
- KV 缓存大小降低 4.44 倍
2️⃣ 原生多模态的视觉 Coding
这是 GLM-5.3-Flash 区别于前代最关键的能力——视觉能力被原生融入 Coding 循环,模型能主动「观察」界面、渲染结果与交互反馈,然后持续测试和改进自己写的代码。
典型场景包括:
- 前端开发:复刻参考图,自主检查渲染效果
- 游戏构建:在 Godot 中实现可玩原型
- 3D 场景:官方演示中,模型自主运行 16 小时在 Blender 里搭出了一套约 400 平方米的专业主厨自宅与测试厨房
- BUA / CUA 闭环:Browser Use Agent 和 Computer Use Agent 能在代码、浏览器和图形界面之间协同工作
3️⃣ 超越 Coding 的工作伙伴
模型不再只会写代码,还能直接交付 Office 成品:
- PPTX / PDF / DOCX / XLSX:能检查并优化自己输出的格式、排版、图表
- 金融场景:基于来源的研究、报告生成、财务建模,保留可追溯引用
- 法律场景:审查合同中的费用、账户与责任条款,按律师惯例批注;起草律师函、合同、诉讼文书,格式符合实务规范
📊 各平台官方数据对照
老张把官方一手数据全部扒了下来,数字和来源都对得上:
🔹 Artificial Analysis 综合智能指数(v4.1.1)
| 模型 | AA 智能指数 | 备注 |
|---|---|---|
| Claude Opus 4.8 | 57 | GLM-5.3-Flash 官方对标 |
| GLM-5.3-Flash | 57 | 官方公布,与 Opus 4.8 同分 |
| GLM-5.3(max) | 60 | Reddit 网友测评,比 Flash 高 3 分 |
| Kimi K3 | 60 | 与 GLM-5.3 持平 |
官方原话:GLM-5.3-Flash 进入全球前沿模型区间,与 Anthropic Claude Opus 4.8 得分持平。 ——智谱 AI 官方发布稿
🔹 编程与 Agent 能力(官方对比)
| 测试项 | GLM-5.2 | GLM-5.3-Flash | 提升 |
|---|---|---|---|
| DeepSWE v1.1 | 46.2 | 63.4 | +17.2 |
| AutomationBench | 26.2 | 48.8 | +22.6 |
| Z.ai Code Bench(最高推理强度) | - | 29.0(Opus 4.8: 29.5) | 已非常接近 |
🔹 价格对比(OpenRouter 官方页面)
| 模型 | 输入 $/1M tokens | 输出 $/1M tokens | 缓存读取 $/1M |
|---|---|---|---|
| GLM-5.3-Flash(限时 5 折,到 2026-09-09) | $0.075 | $0.25 | $0.015 |
| GLM-5.3-Flash(原价) | $0.15 | $0.50 | - |
| GLM-5.3 | $1.40 | $4.40 | $0.26 |
| DeepSeek V4 Flash 0731 | $0.03 | $0.075 | - |
| Qwen3.7 Flash | $0.03 | $0.13 | - |
| Claude Opus 4.8 | ~$15 | ~$75 | - |
结论:按 OpenRouter 限时折扣价计算,输入价是 GLM-5.3 的 约 1/19、输出价 约 1/18;智谱官方对标 Claude Opus 4.8 的说法是 1/40(官方原文表述)。
⚠️ 价格时效性提醒:OpenRouter 的 5 折优惠仅到 2026-09-09 16:00 UTC,届时会恢复原价 $0.15 / $0.50 每 1M tokens。
🌐 多平台覆盖情况
模型已在全球范围内同步上线:
- 智谱 BigModel 开放平台:glm-5.3-flash Model Code,1M 上下文,已纳入 GLM Coding Plan(额度比 GLM-5.3 多 3 倍)
- OpenRouter:
z-ai/glm-5.3-flash,确认就是此前的匿名「Ox Alpha」模型 - OpenCode:发布前一周已上线测试,曾登顶调用量榜首
- Hugging Face:MIT 协议开源权重,可本地部署(vLLM、SGLang、KTransformers 等框架)
🛠️ 跑在国产芯片上
这是一个值得老张单独拎出来说的点——GLM-5.3-Flash 的全部流量都由国产 AI 芯片集群承载。
官方披露的关键信息:
- 芯片:通过自研高带宽互联网络连接的大规模国产加速芯片集群
- 推理引擎:在 SGLang 基础上构建专用推理引擎
- 底层优化:节点内张量并行、ReplaySSM、W8A8 量化、INT8/FP8/BF16 混合缓存量化、Layer Split
- 集群架构:生产级 Encode–Prefill–Decode(EPD)分离式,可独立调度与扩缩容
- 性能提升:与同硬件初始基线相比,端到端服务性能提升 3 倍
- 成本对比:单 token 成本已达到与主流英伟达 GPU 相当的水平
这是开源前沿模型里第一个在大规模流量上跑通国产芯片的案例。
💡 老张的评价
✅ 优点
- 性价比炸裂:OpenRouter 上限时折扣后输入 $0.075 / 1M tokens,AA 智能指数 57 分对标 Opus 4.8(智谱官方原话:「价格是 Opus 4.8 的 1/40」)
- 真·开源:MIT 协议上 Hugging Face,本地可部署,不绑定单一云厂
- 原生多模态:视觉反馈进 Coding 循环,不是外挂视觉模块
- 国产芯片验证:端到端跑通,给国产算力生态打了个样
- 生态成熟:GLM Coding Plan、阿里云千问办公、ZCode 编码平台都已接入
⚠️ 值得注意的地方
- 部分场景有短板:知乎社区测试显示,GLM-5.3-Flash 在某些纯图片识别基准上得分仅 4.8%(同场景 Gemini 3.7 Flash 是 99.9%)——视觉强项在「视觉反馈驱动 Coding」,不是通用 OCR/识图
- 网络安全基准低于 GLM-5.3:KernelBench-Mega 也比 GLM-5.3 弱,需要前沿 Coding Agent 写 GPU Kernel 的场景谨慎评估
- 80% DeepSWE 是误读:早期 10 题小样本曾跑出 80%,扩大样本后回落到 ~63%,社区已澄清
- 时效性提醒:OpenRouter 限时 5 折到 2026-09-09 16:00 UTC,之后会恢复原价
- "登顶榜首"的说法:二级媒体(PANews)转述为「调用量超过 DeepSeek 的两倍、登顶 OpenRouter 榜首」,但智谱官方原文只说"创下双平台调用量新高"和"成为当周最受欢迎",并未用"登顶"二字。严谨起见,以官方原文为准
🎯 适合谁用?
| 场景 | 推荐程度 |
|---|---|
| Agent / 长流程自动化任务 | ⭐⭐⭐⭐⭐ |
| 前端 Coding + 视觉反馈闭环 | ⭐⭐⭐⭐⭐ |
| Office 成品交付(PPT/PDF/Word/Excel) | ⭐⭐⭐⭐ |
| 长上下文(1M)检索与文档分析 | ⭐⭐⭐⭐ |
| 通用 OCR / 纯识图任务 | ⭐⭐ |
| 前沿 GPU Kernel Coding | ⭐⭐⭐ |
🔗 一手资源汇总
| 资源 | 链接 |
|---|---|
| 智谱官方文档 | https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5.3-flash |
| 智谱技术博客 | https://z.ai/blog/glm-5.3-flash |
| OpenRouter 模型页 | https://openrouter.ai/z-ai/glm-5.3-flash |
| 智谱 BigModel 体验中心 | https://bigmodel.cn/trialcenter/modeltrial/visual |
| GLM Coding Plan 订阅 | https://bigmodel.cn/glm-coding |
| Artificial Analysis 评测 | https://artificialanalysis.ai/models/glm-5-3 |
💬 互动话题
- 你觉得 GLM-5.3-Flash 的「视觉反馈驱动 Coding」路线,会成为下一阶段 Agent 的标配吗?
- 如果只看价格,$0.075 / 1M tokens 的输入价,够香吗?你打算把它用在哪个场景?
- 国产芯片跑通前沿模型这件事,对你的工作选型有影响吗?
我是老张,多年运维老兵,关注 AI 工程化落地。下期见。