磁盘故障告警别急着换盘:四层只读排查,揪出一个误报
真实生产排障复盘第二篇。主机名、IP、序列号、内部平台名均已脱敏;上篇《磁盘告警 90% 排查复盘》查的是"盘被什么占满了",这篇更刺激——告警说盘直接丢了。
先说结论:一条 "Disk: Lost (Unrecognized)" 的 Critical 告警,告了一整天。四层证据(OS / 盘体 / 带外 / 内核)查完,盘根本没丢——是诊断平台单轮扫描超时判出的误报,数据零风险,最后连一块盘都没换、一根线都没插。 处置只剩一件事:平台侧关单。
晚上 19:50 过后,群里炸出一条 Critical:磁盘故障,Disk Lost (Unrecognized),一台对象存储节点的数据盘"丢失未识别"。
搞运维的都懂这类告警的分量:盘丢了 → 掉线 → 重建 → 数据风险,一条龙。但真上手之前,老规矩不变:先只读查清"是什么",再决定"动不动"。 下面全程 lsblk、smartctl、ipmitool、journalctl,全是可以随便敲的查询类命令。
先读懂告警本身,关键字段(已脱敏):
{
  "rule_name": "[iaas][诊断平台]Disk磁盘故障",
  "severity": "Critical",
  "ResourceId": "<IP>_5",
  "HostName": "tos-xxx",
  "FaultEvent": "Disk: Lost (Unrecognized)",
  "FaultCode": 280xx,
  "Device": "5",
  "DeviceSN": "ZVTBBZ**",
  "_status": "executing"
}
逐字段解读:
Device: 5是 0 起始编号(sda=0,sdb=1……),5 号就是 sdf;Lost (Unrecognized)= 扫描方没能在盘面枚举里读到这块盘的身份信息(INQUIRY 失败或超时)时的判定措辞——注意,这是"扫描方"的说法,不是盘的遗言;_status: executing= 工单流程一直"执行中"、未闭环——这是后面"为什么告一整天"的伏笔;- 背景补充:sdf1 挂载 /xxx08,是对象存储的数据盘。
事件速览:
| 项目 | 内容 |
|---|---|
| 告警 | Disk: Lost (Unrecognized),Critical,反复推送 |
| 对象 | 12 盘 SATA + 3 盘 NVMe 存储节点的 /dev/sdf(挂 /xxx08) |
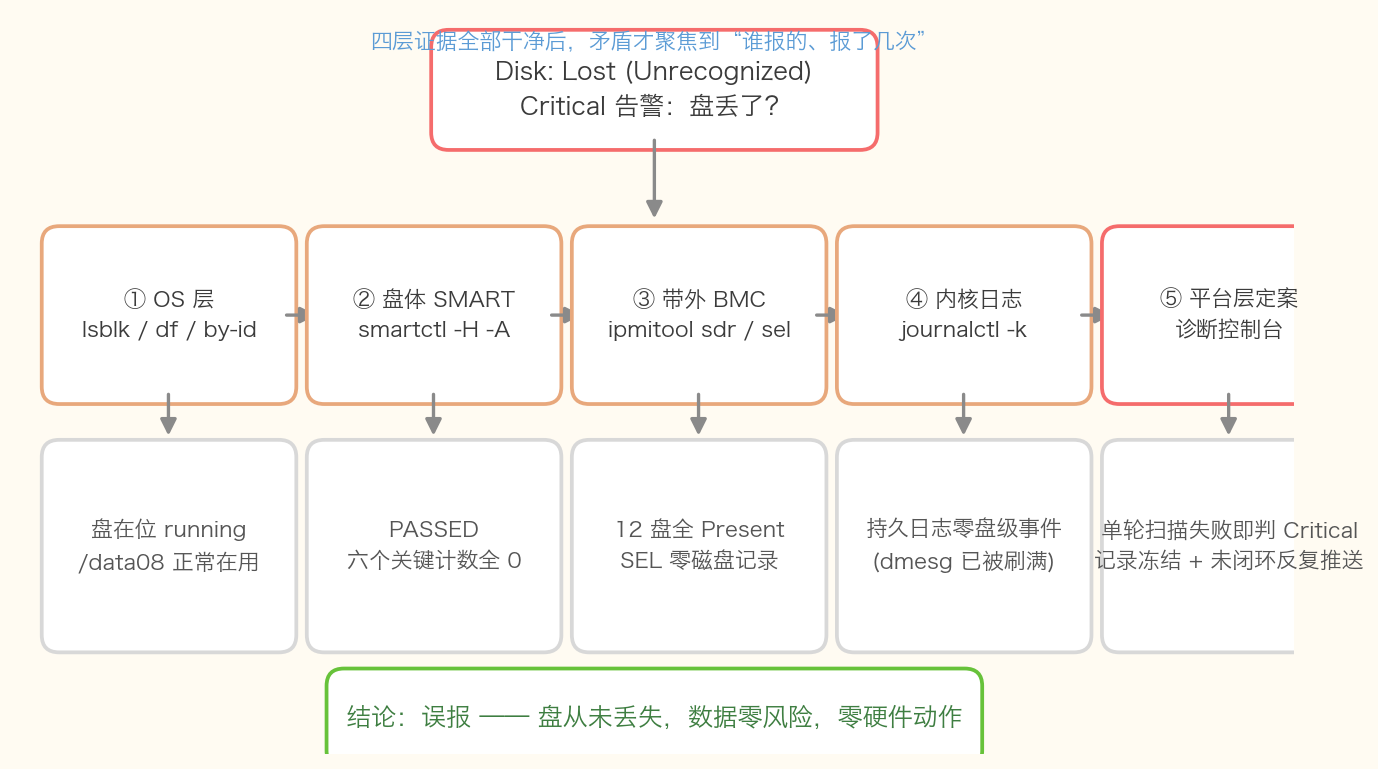
| 排查 | OS → 盘体 → 带外 → 内核 → 平台,五层,全程只读 |
| 根因 | 平台周期扫描撞上控制器忙,单轮超时误判 + 记录无恢复机制 |
| 处置 | 主机零动作,平台侧关单 + 反馈三个问题 |
第一层:OS——告警说它丢了,它却在列表里站着
登录 tos-06,先看盘在不在(只读)。
输入:
lsblk -d -e7 -o NAME,SIZE,MODEL,SERIAL,STATE
输出:
NAME     SIZE MODEL                 SERIAL     STATE
sda     16.4T ST18000NM003D-3D      ZVTBJL**   running
sdb     16.4T ST18000NM003D-3D      ZVTBEL**   running
sdc     16.4T ST18000NM003D-3D      ZVTBK6**   running
sdd     16.4T ST18000NM003D-3D      ZVTBGK**   running
sde     16.4T ST18000NM003D-3D      ZVTBAP**   running
sdf     16.4T ST18000NM003D-3D      ZVTBBZ**   running   ← 故障盘,还在!
sdg     16.4T ST18000NM003D-3D      ZVTBAJ**   running
sdh     16.4T ST18000NM003D-3D      ZVTB52**   running
sdi     16.4T ST18000NM003D-3D      ZVTBCC**   running
sdj     16.4T ST18000NM003D-3D      ZVTB3Y**   running
sdk     16.4T ST18000NM003D-3D      ZVTBCT**   running
sdl     16.4T ST18000NM003D-3D      ZVTBDB**   running
nvme0n1  1.8T INTEL SSDPF2KX019T1M  PHAX****   live
nvme1n1  1.8T INTEL SSDPF2KX019T1M  PHAX****   live
nvme2n1  1.8T INTEL SSDPF2KX019T1M  PHAX****   live
【解读】 12 块希捷 Exos 18TB(sda~sdl)加 3 块 Intel NVMe,全部在位,状态全是 running。告警里的 Device=5 换算过来正是 sdf——告警说它丢了,它好端端在列。第一层就和告警矛盾了。
再看一个容易被忽略的细节——设备映射的"履历":
输入:
ls -l /dev/disk/by-id/ | grep -i zvtb
df -h /xxx08
输出:
lrwxrwxrwx 1 root root  9 Aug 29  2024 ata-ST18000NM003D-3DL103_ZVTBBZ** -> ../../sdf
lrwxrwxrwx 1 root root 10 Aug 29  2024 ata-ST18000NM003D-3DL103_ZVTBBZ**-part1 -> ../../sdf1

Filesystem      Size  Used Avail Use% Mounted on
/dev/sdf1        17T  691G   16T   5% /xxx08
【解读】 两条证据各说各话:
- by-id 链接是 udev 按盘的真实身份生成的,盘若中途掉过线、重新枚举过,链接会重建、时间戳会更新。它停在 2024-08-29 接入那天,从未变过;
- /xxx08 挂载正常、数据目录健在,业务读写路径完全正常。
OS 层结论:盘从未离开过系统。
第二层:SMART——六个关键计数,全是 0
盘没丢不代表盘没病。万一是"快坏的盘被扫描探出了异常"呢?接着验身体:
输入:
sudo smartctl -H -A /dev/sdf
sudo smartctl -l error /dev/sdf
输出(属性表节选,关键行加注释):
SMART overall-health self-assessment test result: PASSED

ID# ATTRIBUTE_NAME          FLAGS  VALUE WORST THRESH TYPE      WHEN_FAILED RAW_VALUE
  1 Raw_Read_Error_Rate     0x000f  077   064   044   Pre-fail  Always       53620776
  5 Reallocated_Sector_Ct   0x0033  100   100   010   Pre-fail  Always       0        ← 0
  9 Power_On_Hours          0x0032  071   071   000   Old_age   Always       25482
187 Reported_Uncorrect      0x0032  100   100   000   Old_age   Always       0        ← 0
188 Command_Timeout         0x0032  100   100   000   Old_age   Always       0        ← 0
190 Airflow_Temperature_Cel 0x0022  069   035   000   Old_age   Always       31
194 Temperature_Celsius     0x0022  031   065   000   Old_age   Always       31
197 Current_Pending_Sector  0x0012  100   100   000   Old_age   Always       0        ← 0
198 Offline_Uncorrectable   0x0010  100   100   000   Offline   Always       0        ← 0
199 UDMA_CRC_Error_Count    0x003e  200   200   000   Old_age   Always       0        ← 0
(其余属性均正常,略)

=== START OF READ SMART DATA SECTION ===
SMART Error Log Version: 1
No Errors Logged
【解读】 六个关键计数全部为 0:
| 关键计数 | 含义 | 值 |
|---|---|---|
| Reallocated_Sector_Ct | 已重映射坏扇区 | 0 |
| Current_Pending_Sector | 待重映射可疑扇区 | 0 |
| Offline_Uncorrectable | 不可修复扇区 | 0 |
| Reported_Uncorrect | 上报不可纠正错误 | 0 |
| UDMA_CRC_Error_Count | 链路错误指纹(线缆/背板) | 0 |
| Command_Timeout | 命令超时次数 | 0 |
通电 25482 小时(约 2.9 年)、温度 31°C、错误日志空白——一块健康服役中的盘。后两个 0 尤其关键:真发生过链路瞬断或命令超时,这两处大概率留痕,而它干干净净。
顺带提醒:第 1 行 Raw_Read_Error_Rate 原始值巨大别慌,这是希捷固件的编码方式,归一化值(077)在正常范围,不是真实错误。
第三层:带外 BMC——另一双眼睛,同样干净
OS 看不到的,BMC 可能看得到;用带外的独立视角交叉验证:
输入:
sudo ipmitool sdr elist | grep -iE 'disk|drive|hdd|nvme'
sudo ipmitool sel list | tail -5
输出(节选):
HDD0_Status      | 7Bh | ok  |  4.0 | Drive Present
HDD1_Status      | 7Ch | ok  |  4.0 | Drive Present
HDD2_Status      | 7Dh | ok  |  4.0 | Drive Present
HDD3_Status      | 7Eh | ok  |  4.0 | Drive Present
HDD4_Status      | 7Fh | ok  |  4.0 | Drive Present
HDD5_Status      | 80h | ok  |  4.0 | Drive Present    ← 5 号位,Present!
(HDD6~11 同样全部 Drive Present,略)
NVME0~2_Status   | 93h~95h | ok | 4.0 | Drive Present

  4c | 04/05/2026 | 02:08:38 | Power Supply #0x52 | Predictive failure | Asserted
  4d | 04/05/2026 | 02:12:48 | Temperature #0x1d  | Upper Critical going high | Asserted
  67 | 04/05/2026 | 02:40:21 | Temperature | Upper Non-critical going high | Deasserted
【解读】 BMC 眼里 15 块盘全部 "Drive Present"、无任何故障位。SEL 事件日志的最后一条停在 2026-04-05(一次进风高温,已恢复)——四个多月来带外层零记录。盘真从背板掉过,BMC 通常会留痕。
第四层:内核日志——这里踩到一个经典坑
带内日志一看"没有盘级报错"?先别急着下结论:
输入:
dmesg | wc -l
dmesg -T | grep -ci mpt3sas
dmesg -T | tail -3
输出:
5460
5460
[Tue Sep 22 09:01:55 2026] mpt3sas_cm0: log_info(0x30030109): originator(IOP), code(0x03), sub_code(0x0109)
[Tue Sep 22 09:01:55 2026] mpt3sas_cm0: log_info(0x30030109): originator(IOP), code(0x03), sub_code(0x0109)
[Tue Sep 22 09:01:55 2026] mpt3sas_cm0: log_info(0x30030109): originator(IOP), code(0x03), sub_code(0x0109)
【解读】 环形缓冲区 5460 行,100% 全是同一条 mpt3sas 消息——这 12 块 HDD 挂在 mpt3sas(LSI SAS 控制器)驱动后面,控制器在以约 12 分钟一轮的固定节奏刷 SAS 域通知。log_info(0x30030109) 按 MPI 规范解码:originator=IOP(控制器固件),是域通知,不是介质错误(介质错误是 PL 来源且伴随盘符报错)。
也就是说:dmesg 的"干净"是假象——缓冲区被噪音灌满,其他内核消息早被冲走了。 换持久日志说话:
输入:
sudo journalctl -k --since "2026-09-21 18:00" --no-pager \
  | grep -iE 'sdf|ata[0-9]|I/O error|reset|offline'
输出:
(空——从告警当晚 18:00 起,内核层零盘级事件)
【解读】 journalctl 是持久日志,不受环形缓冲冲刷影响。没有 sdf 掉线、没有 reset、没有 I/O error。带内彻底干净,四层全绿。
第五层:平台侧——定案的决定性证据
主机侧全干净,矛盾聚焦到两个问题:"谁报的?为什么一直报?" 打开硬件故障诊断平台的机器详情页,故障记录是这么写的:
| FailureTime | UpdateTime | FaultCode | Source | FaultTicket |
|---|---|---|---|---|
| 09-21 19:50:18 | 09-21 19:50:18(再没变过) | 28063 | OS | No |
【解读】 五个决定性信息:
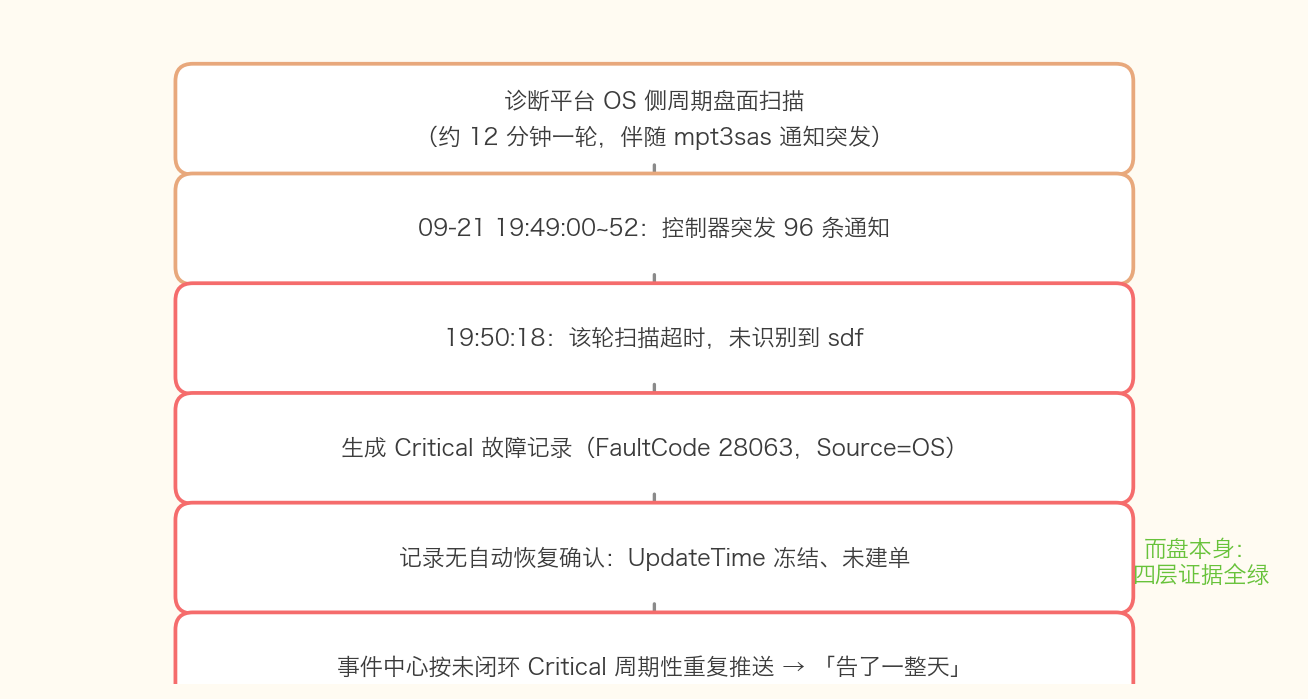
- FailureTime = UpdateTime:记录生成后再未更新——只有 19:50:18 那一轮失败,此后没有再触发;
- Source=OS:探测走的是平台远程执行的系统扫描(主机上本就没有 agent,
ps aux和/var/log都查过,无此进程无此日志); - FaultTicket=No:未建单、未闭环 → 事件中心把这条未处理 Critical 按周期反复推送——这就是"从昨晚告警到现在"的直接原因;
- 平台页面的 OSEvent / BMCEvent 两个 tab 全空:故障是扫描层"自己判出来的",盘上什么都没发生。
最后一问:那轮扫描为什么会失败?
把故障时间窗(19:40~20:00)的日志倒出来对时间线:
输入:
sudo journalctl -k --since "2026-09-21 19:40" --until "2026-09-21 20:00" --no-pager \
  | grep 'mpt3sas_cm0' | awk '{print $3}' | cut -c1-8 | sort | uniq -c
输出:
     23 19:49:00
     39 19:49:01
     16 19:49:02
      6 19:49:45
      3 19:49:46
      4 19:49:51
      5 19:49:52
【解读】 突发集中在 19:49:00~19:49:52(合计 96 条),而失败判定发生在 19:50:18——紧随突发结束约 26 秒。再过滤掉 mpt3sas 噪音看同窗口内核:零消息;系统日志:只有 containerd 例行的容器资源更新,无 OOM、无异常登录。
最简解释链:那轮平台扫描的 SMART/INQUIRY 类查询恰好撞上控制器忙的窗口,超时未返回,被诊断层判成"盘丢了"。
误报不是"平台瞎报",是"单轮失败即 Critical + 没有恢复确认机制"——一次抖动被冻结成了持续告警。
处置:主机零动作,平台背走这口锅
| 动作 | 说明 |
|---|---|
| 主机与硬件 | 零动作:不换盘、不重插、不跑自检、不清 SEL |
| 平台侧 | 提单关单,停止重复推送 |
| 顺带反馈三个问题 | ① 单轮失败即判 Critical、无自动恢复确认,建议 N 轮确认;② 详情页链接打不开;③ dmesg 被 mpt3sas 通知刷满的问题 |
什么情况才需要转真实故障流程?SMART 关键计数非零,或 journalctl 出现 sdf 级事件——在此之前,稳住不动就是最优解。
可复制的命令速查(脱敏版)
# ── OS 层:在位与使用 ──────────────────────
lsblk -d -e7 -o NAME,SIZE,MODEL,SERIAL,STATE    # 盘在位/状态
ls -l /dev/disk/by-id/ | grep -i <SN前缀>        # 映射+链接时间戳(掉过线会更新)
df -h /xxx08                                     # 挂载与使用

# ── 盘体 ──────────────────────────────────
sudo smartctl -H -A /dev/sdX                     # 健康+关键计数
sudo smartctl -l error /dev/sdX                  # 错误历史

# ── 带外 ──────────────────────────────────
sudo ipmitool sdr elist | grep -iE 'disk|drive|hdd|nvme'
sudo ipmitool sel list | tail -30

# ── 内核(排除刷屏噪音的正确姿势)──────────
sudo journalctl -k --since "…" --no-pager \
  | grep -v 'mpt3sas_cm0: log_info' \
  | grep -iE 'sd[a-z]+|ata[0-9]+|reset|remov|offline|I/O err|fail'

# ── 刷屏量化与突发分布 ─────────────────────
dmesg | wc -l                                    # 环形缓冲总行数
dmesg -T | grep -ci <噪音关键字>                  # 噪音占比(本次 5460/5460)
dmesg -T | grep -i mpt3sas | head -5             # 缓冲区内最早一条
sudo journalctl -k --since "…" --until "…" --no-pager \
  | grep 'mpt3sas_cm0' | awk '{print $3}' | cut -c1-8 | sort | uniq -c   # 突发分钟分布
这次排查留下 4 个教训
- "Lost (Unrecognized)"是扫描方的措辞,不是盘的遗言。 它只说明"扫描那一刻没读到盘的身份信息",超时也能触发,和盘真丢了是两回事。
- 判断盘的真假丢失,看四层证据链:OS 在位、SMART 关键计数、BMC SDR/SEL、持久内核日志。四层全绿,就别让手去碰硬件。
- dmesg 的"干净"可能是被噪音刷出来的假干净,盘级排查一律以 journalctl 持久日志为准。
- 告警反复推送 ≠ 故障反复发生。 查一下记录的 UpdateTime 是否冻结、有没有建单——"未闭环所以循环通知"是很多平台的行为模式。
🎯 老张建议
- 硬件 Critical 告警的第一反应是建证据链,不是建工单。四层只读命令半小时能跑完,误报就止损了,真故障证据也齐了。
- 平台同学值得被"挑战":单轮扫描失败就 Critical、无恢复确认、无自动闭环,这类设计在磁盘多的集群里就是误报放大器,提单时把因果链一起递上去,比只说"误报"有说服力得多。
- 养成习惯:排查内核问题先
dmesg | wc -l再grep -c 噪音,确认缓冲区没被灌满,再看日志。
💬 互动话题
- 你遇到过硬件告警误报吗?最后是怎么"自证清白"的?
- 磁盘告警你们的第一反应是换盘还是先建证据链?(上篇磁盘 90% 那篇的评论区也有人说"直接删日志",欢迎来聊)
🔗 关注老张
公众号:老张聊运维 小程序:观简国学 个人博客:https://www.shanwaiyun.top/