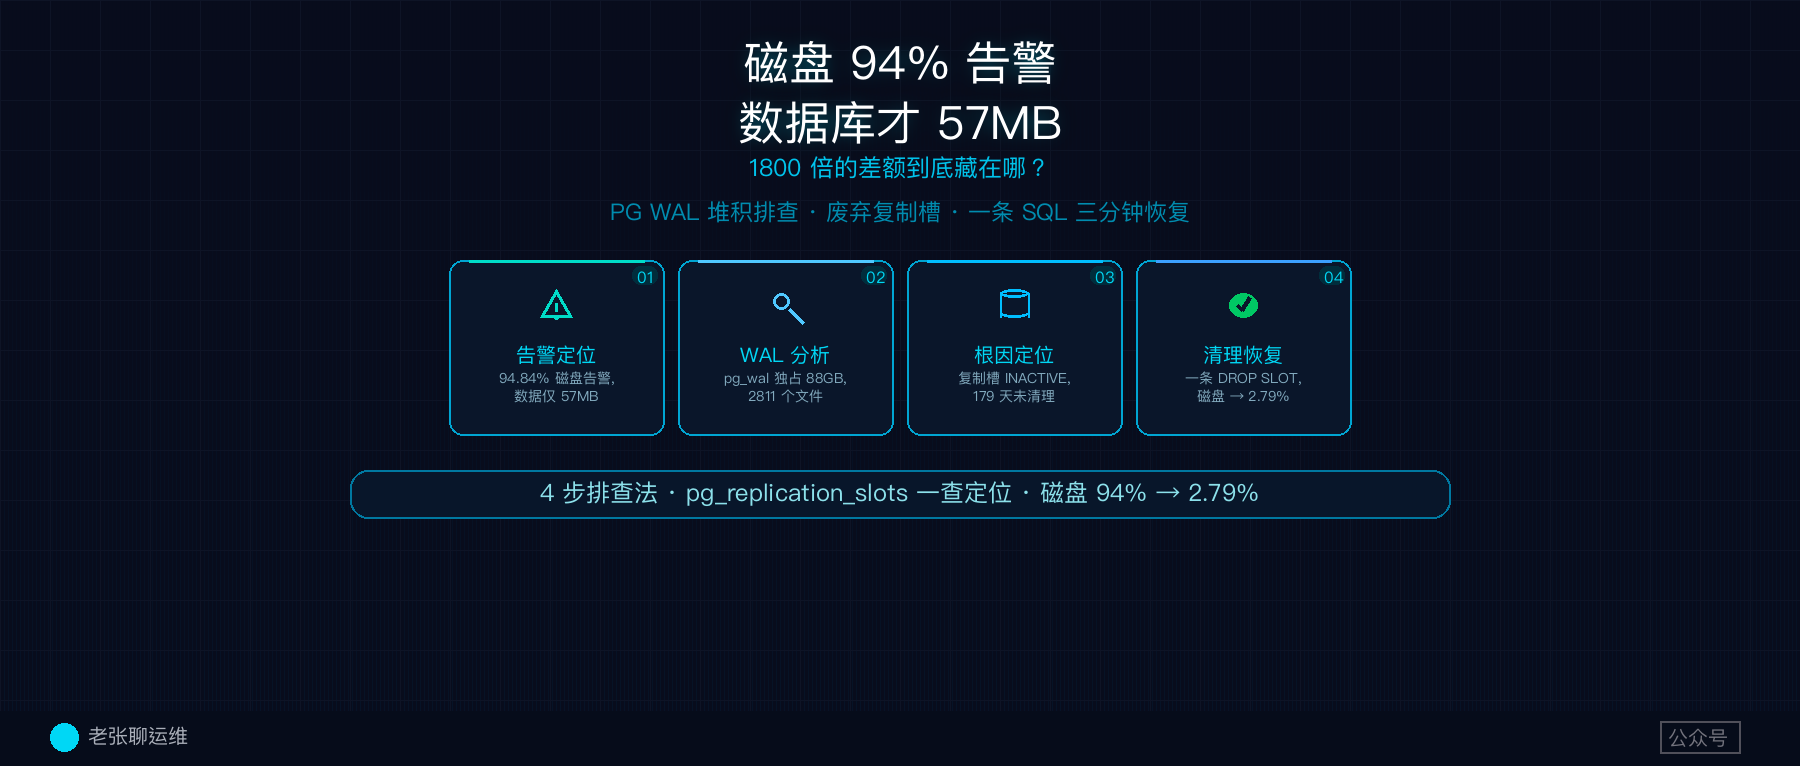
磁盘 94% 告警,数据库才 57MB——1800 倍的差额到底藏在哪?
大家好,我是老张。
上午10 点,手机震了——「PG 实例磁盘使用率超过 90%,当前值 94.84%」。
迷迷糊糊爬起来,打开控制台一看:实例规格 100GB 磁盘,已经吃掉了 94.84GB。第一反应——是不是业务库数据暴增了?
结果进库一看:
  datname   |  size
------------+---------
 业务库     | 57 MB
 postgres   | 8873 kB
 template1  | 8385 kB
57MB。 整个业务库的数据加起来才 57MB,磁盘却占了 94GB。差了 1800 倍。
这不是数据的问题。剩下的 94GB 到底是什么?
📊 告警来了 → 第一层:控制台确认
告警原文(已脱敏):
[Database][RDS_PG] 实例磁盘使用率超过 90%
实例:某 PG 14 实例(4C8G,100GB 本地 SSD)
当前值:94.84%
登录控制台 → 实例详情 → 「服务可用性」页面:
| 指标 | 数值 |
|---|---|
| 磁盘总量 | 100 GB |
| 磁盘使用率 | 94.84% |
| 数据 | 57 MB |
| WAL 日志 | 94.2 GB ← 这里 |
一眼定位——不是数据膨胀,是 WAL 日志占了 94GB。
关键判断:控制台「服务可用性」页面分拆了数据 / WAL / 其他日志的占比,省去了进 Pod 盲猜的环节。收到磁盘告警第一步先看这个分拆,不要上来就怀疑数据疯涨。
🔬 第二层:进 Pod,确认 WAL 堆积
进主节点 Pod 看文件系统:
$ du -sh /pgdata/
88G     /pgdata/
$ du -ah /pgdata/ | sort -rh | head -5
88G     /pgdata/xxx/pg_wal        ← 88GB
88G     /pgdata/xxx
83M     /pgdata/xxx/base
58M     /pgdata/xxx/base/16501
pg_wal 目录独占 88GB。数一下文件:
$ ls /pgdata/xxx/pg_wal/ | wc -l
2811
2811 个 WAL 文件。 正常的 PG 实例,WAL 文件数通常在两位数(几十到一百),2800+ 明显不正常。
🎯 第三层:根因定位——废弃复制槽
PG 的 WAL 为什么不被清理?最常见的原因是 复制槽(Replication Slot)——主库给备库留的"书签"。
SELECT slot_name, active,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)
       ) AS wal_retained
FROM pg_replication_slots;
结果:
              slot_name               | active | wal_retained
--------------------------------------+--------+--------------
 postgres_xxxx_fdfdf795f_psg8v        | f      | 88 GB
就一个槽,INACTIVE,堆积了 88GB。
PG 的机制:只要复制槽存在——不管 ACTIVE 还是 INACTIVE——restart_lsn 之前的 WAL 就全部保留,不会被 checkpoint 回收。
这个槽是谁创建的?槽名里的 psg8v 是备节点 Pod 的随机后缀。备节点在 179 天前重建过,Pod 名变了,新 Pod 用了新的复制槽,但旧槽没有被自动删除,成了孤儿。
🛡️ 删槽前的安全性验证
删槽不可逆,删错了备库同步会断。先做三步验证:
| 检查项 | 命令 | 结果 | 结论 |
|---|---|---|---|
| 备节点是否有槽 | 进备节点查 pg_replication_slots | 0 rows | 备节点不用这个槽 |
| 主节点活跃复制 | 查 pg_stat_replication | 0 rows | 无任何复制连接 |
| 废弃槽 lag | pg_wal_lsn_diff(...) | 87.7 GB | 纯堆积,无人使用 |
三项交叉验证通过 → 安全删除。
🔧 处理
SELECT pg_drop_replication_slot('postgres_xxxx_fdfdf795f_psg8v');
一条 SQL,删了槽。
但 WAL 不会立刻回收——PG 的 checkpoint 是异步的,加上归档(pgbackrest)需要追完积压队列。本例堆积了 2800+ 个 WAL 文件,等了约 10 分钟。
📈 处理效果
| 指标 | 处理前 | 处理后 |
|---|---|---|
| 磁盘使用率 | 94.84% | 2.79% |
| WAL 目录大小 | 88 GB | 2.1 GB |
| WAL 文件数 | 2811 | 67 |
94.84% → 2.79%,告警消除 ✅
🧠 老张的几点总结
1. 磁盘告警,先看控制台分拆
不要上来就 du -sh。控制台的「服务可用性」页面已经把数据/Binlog/WAL/其他日志的比例列出来了。一眼就能判断是数据膨胀还是日志堆积,省掉大半排查时间。
2. 数据 57MB、磁盘 94GB → 99% 是 WAL 堆积
这种"数据小、磁盘满"的极端反差,基本锁定 WAL 堆积。下一步直接查复制槽。
3. 复制槽排查三步
-- ① 看有没有堆积
SELECT slot_name, active,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn))
FROM pg_replication_slots;

-- ② 看有没有人在用
SELECT * FROM pg_stat_replication;

-- ③ 交叉验证:备节点查自己的槽
-- (进备 Pod 执行)
SELECT * FROM pg_replication_slots;
三步走完,INACTIVE + 无复制连接 + 备节点不用此槽 → 安全删除。
4. 废弃槽不会自动清理
PG 管控侧不会自动检测和清理 INACTIVE 的复制槽。备节点重建、重配、或主备切换场景下,旧槽容易变成孤儿。建议纳入日常巡检:pg_replication_slots 中 active = false 且 wal_retained > 10GB 的槽需要人工确认后清理。
📋 排查清单(建议收藏)
- 控制台 → 实例详情 → 服务可用性 → 看数据/WAL/日志分拆
- 如果 WAL 占比高 → 进 Pod,
du -sh /pgdata/*/pg_wal/ -
ls pg_wal/ | wc -l确认文件数(正常 < 200) -
SELECT * FROM pg_replication_slots查槽状态 -
SELECT * FROM pg_stat_replication确认活跃连接 - 备节点
pg_replication_slots交叉验证 - 三项验证通过 →
pg_drop_replication_slot('槽名') - 等 5-10 分钟,控制台确认磁盘恢复
💬 互动话题
- 你遇到过 PG WAL 堆积的问题吗?最终是什么原因导致的?
- 你们公司的 PG 巡检有没有覆盖复制槽状态?多久查一次?
- 除了复制槽,还有哪些情况会导致 WAL 不回收?评论区聊聊