磁盘90%告警,集群却全是绿的:这次生产排错,查出10天倒计时
凌晨 23:52,告警群弹了一条 Critical:生产某节点一块盘,使用率 90.01%。
第一预感:要么日志炸了,要么谁往盘里塞了垃圾。
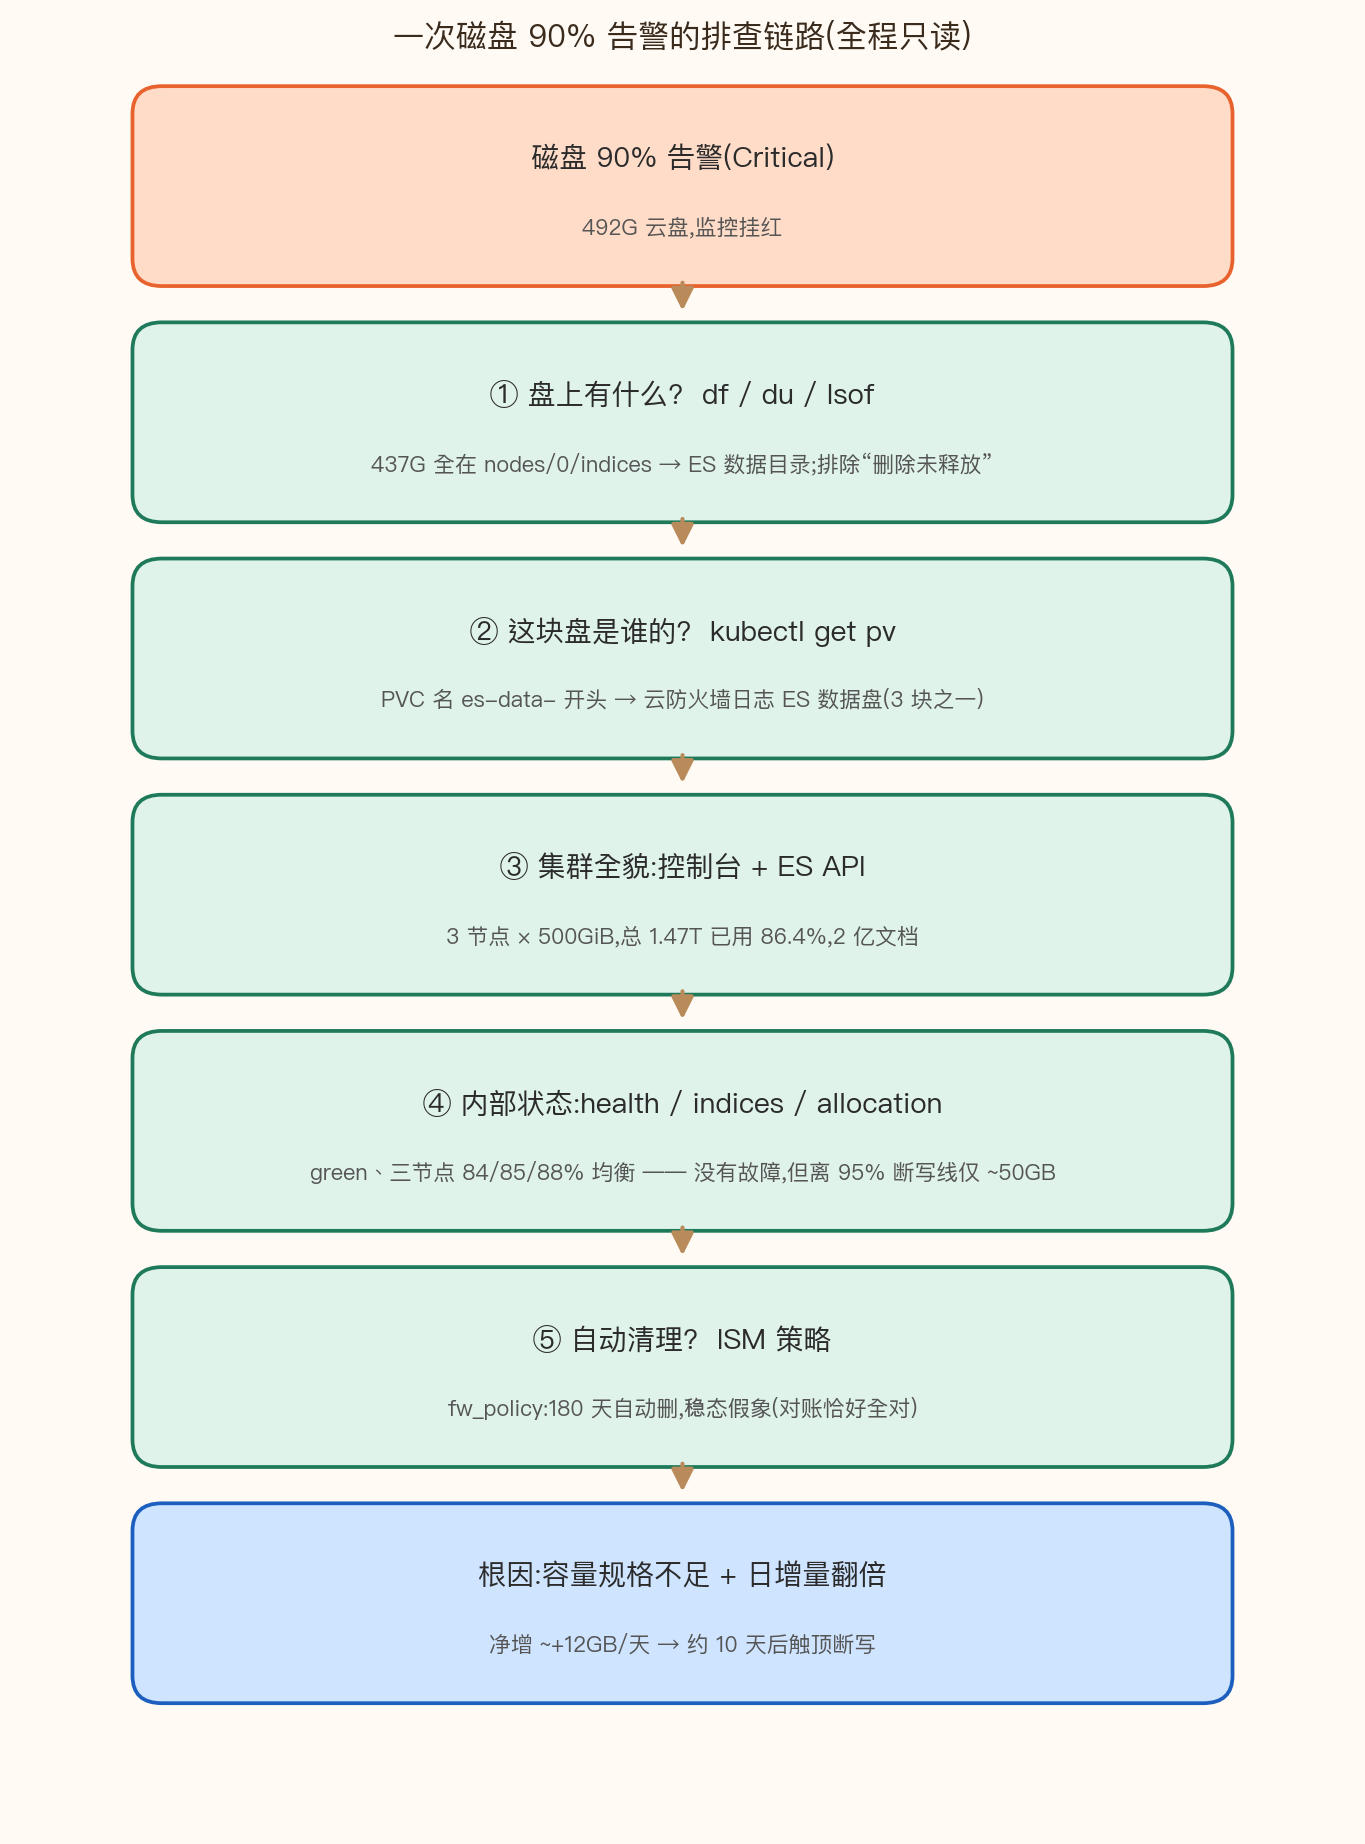
查到底,结论出乎意料——集群 green、数据正常、没有故障、没有异常占用。但按当时的增速,10 天后这块盘会撞上断写线,防火墙日志直接写不进来。
最吓人的告警,不是"坏了",是"快装满了"。
这篇把全过程摊开:每一步的命令、输出、解读都贴出来,可直接抄作业。全程只读,生产环境一根手指头都没动。(主机名、IP、实例 ID、密码均已脱敏)
事件速览
| 项目 | 内容 |
|---|---|
| 告警 | 物理机磁盘使用率 ≥90%,Critical |
| 对象 | 一块 492G 云盘,K8s 容器挂载 |
| 结论 | 非故障:云防火墙日志 ES 集群,容量配小了 + 日增量翻倍 |
| 处置 | 确认新功能属规划内,数据盘按需扩容,当日完成并验证 |
第一步:告警本身就是线索库
告警关键字段不多,但全是肉:
{
  "rule_name": "[physical]磁盘使用率",   ← 260 号规则:磁盘 ≥90% 就报 Critical
  "severity":  "Critical",
  "hostname":  "node-xx-08",                  ← 已脱敏
  "device":    "nbdxxx",
  "value":     "90.01",
  "path": "/var/lib/kubelet/pods/<POD_UID>/volumes/kubernetes.io~csi/<PVC_ID>/mount"
}
三个字段值得停下来看:
device: nbd3—— nbd = Network Block Device,网络块设备,一块通过网络挂上来的云盘,不是机器本地盘;value: 90.01—— 刚过 90% 阈值;path—— 带kubelet/pods字样,说明这是 K8s 里某个容器挂载的云盘。
重点是那条挂载路径,K8s 把两个关键 ID 直接写在了里面:
/var/lib/kubelet/pods/<POD_UID>/volumes/...csi/<PVC_ID>/mount
                        └─ 谁在用这块盘        └─ 盘的"申请单"编号
小白术语:PVC(持久卷声明)= K8s 里容器"申请一块盘"的凭证,一块 PVC 对应一块真实云盘。
这两个 ID,就是后面全程追查的抓手。告警字段别扫一眼就关,读懂它,一半排查路线已经画好了。
第二步:上机三板斧,全是只读
2.1 df -h 验真假
输入:
MOUNT=/var/lib/kubelet/pods/<POD_UID>/volumes/kubernetes.io~csi/<PVC_ID>/mount
df -h "$MOUNT"
df= 看文件系统整体容量和使用率;-h= 人类可读单位。
输出:
Filesystem      Size  Used Avail Use% Mounted on
/dev/nbd3       492G  437G   55G  89% /var/lib/kubelet/pods/.../mount
【解读】 492G 用了 437G,剩 55G,和告警的 90.01% 吻合。盘是真满,不是监控误报。
2.2 du 看谁占的
输入:
sudo du -xh --max-depth=1 "$MOUNT" | sort -rh | head -10
du= 逐目录统计占用;--max-depth=1= 只看第一层;sort -rh= 按大小倒序。
输出:
437G    .../mount/nodes
437G    .../mount
16K     .../mount/lost+found
【解读】 437G 几乎全在 nodes/ 一个目录里,而 nodes/0/indices/... 正是 Elasticsearch 数据目录的标准布局。第一次露出马脚:这盘八成是 ES 的数据盘。
2.3 lsof +L1 排经典坑
输入:
sudo lsof +L1 | sort -k7 -rn | head -5
lsof +L1= 列出"已被删除、但仍被进程打开"的文件。这类文件df里占着空间、du却找不到,是磁盘告警的头号惯犯,必须先排除。
输出:
java     37992  root   35w  REG   0,324  2147493845  /root/logs/app/xxx.log.10 (deleted)
python3  71412  root    6w  REG   259,4   129021310  /opt/log/xxx/agent.log.2026-04-05 (deleted)
【解读】 确实有"删了没释放"的文件,但看设备号:0,324、259,4 都不是 nbd3,路径也在别的盘上。排除。 这 437G 是实打实的活数据。
第三步:这块盘是谁的?拿 PVC ID 问 K8s
输入:
kubectl get pv <PVC_ID> -o jsonpath='{"ns: "}{.spec.claimRef.namespace}{"\npvc: "}{.spec.claimRef.name}{"\ncapacity: "}{.spec.capacity.storage}{"\n"}'
PV 是 PVC 背后那块真实的盘。这条只读命令一次查出:PVC 属于哪个命名空间、叫什么名、多大。
输出:
ns: fw-xxx(命名空间,已脱敏)
pvc: es-data-xxxxx-2
capacity: 500Gi
【解读】 三个信息一次到位:PVC 名字 es-data- 开头,石锤 Elasticsearch 数据盘;结尾 -2,是全集群 3 块数据盘里的第 2 块;500Gi,和 df 看到的 492G 对得上(差的 8G 是文件系统格式化开销,正常)。
再去控制台看实例全貌:云防火墙产品专用的托管 ES,3 个数据节点 × 500GiB,合计 1.47TB,已用 1.27TB(86.4%),监控页挂红。581 个索引,2 亿文档。
到这里,告警对象定位完毕:不是单点异常,是整个集群都满。
第四步:进集群看内部,反常的"健康"
先定义变量(在能连通 ES 地址的跳板机上执行,全部 GET,只读):
ES="http://<ES内网地址>:9200"    # 控制台实例详情页能拿到
AUTH="xxx:********"            # 账户密码已脱敏,从控制台获取;千万别点"重置密码"——
                                 # 服务正拿这个账号写日志,重置等于亲手断写
4.1 集群健康度
输入:
curl -s -u "$AUTH" "$ES/_cluster/health?pretty"
输出:
{
  "cluster_name" : "fw-xxx",
  "status" : "green",
  "number_of_data_nodes" : 3,
  "active_primary_shards" : 581,
  "active_shards" : 1163,
  "unassigned_shards" : 0
}
【解读】 green = 所有数据都有副本、无丢失;unassigned: 0 = 没有掉队的分片。排除"集群坏了导致占用异常"。
4.2 索引大小排行
输入:
curl -s -u "$AUTH" "$ES/_cat/indices?v&h=health,index,docs.count,store.size&s=store.size:desc" | head -10
_cat/indices= 列出所有索引(ES 里一张"表"就叫一个索引);s=store.size:desc= 按占用倒序。
输出(Top 10):
health index                  docs.count store.size
green  fw_session-2026.05.09  16061278   9.6gb
green  fw_session-2026.09.17  13675427   8.6gb
green  fw_session-2026.09.15  13355429   8.4gb
green  fw_session-2026.06.11  13233457   8.3gb
green  fw_session-2026.09.11  12826902   8gb
green  fw_session-2026.09.03  12859019   8gb
...(以下全是 fw_session-日期,略)
【解读】 清一色 fw_session-日期(防火墙会话日志),每个约 8GB、一千多万文档,均匀得像尺子量出来的——典型的按天一个索引滚动日志,没有异常膨胀的大索引。
4.3 三块盘分得均不均
输入:
curl -s -u "$AUTH" "$ES/_cat/allocation?v"
输出(IP 已脱敏):
shards disk.indices disk.used disk.avail disk.total disk.percent host      node
   395     416.6gb   417.1gb     73.9gb    491.1gb         84  10.*.*.*  es-data-0
   373     435.4gb   436.7gb     54.3gb    491.1gb         88  10.*.*.*  es-data-1
   395     417.9gb   418.6gb     72.5gb    491.1gb         85  10.*.*.*  es-data-2
【解读】 84% / 88% / 85%,三节点负载均衡,没有"某块盘被挤爆"的倾斜。最满的 es-data-1(88%)就是挂在告警节点上的那块。
4.4 磁盘水位:三道防线
输入:
curl -s -u "$AUTH" "$ES/_cluster/settings?flat_settings=true&include_defaults=true" \
  | grep -o '"cluster.routing.allocation.disk.watermark[^,}]*'
输出:
"cluster.routing.allocation.disk.watermark.low":"85%"
"cluster.routing.allocation.disk.watermark.high":"90%"
"cluster.routing.allocation.disk.watermark.flood_stage":"95%"
【解读】 全是默认值,三道防线一张表:
| 水位 | 阈值 | 后果 |
|---|---|---|
| low | 85% | 不再往该节点分新数据(84/85/88,已经顶到) |
| high | 90% | 开始把分片搬去别的节点(三个都满,搬不动) |
| flood | 95% | 该节点索引全部只读,日志写入直接中断 ← 最危险 |
集群没病,但离断写线只剩约 50GB。
第五步:有没有自动删旧日志?
数据堆了快 6 个月,关键就看有没有自动清理机制。
5.1 先试 ISM 接口 → 报错
输入:
curl -s -u "$AUTH" "$ES/_opendistro/ism/policies?pretty"
输出:
{ "error" : { "reason" : "Invalid index name [_opendistro], must not start with '_'." } }
【解读】 服务端不认识这个路径。查插件清单确认:
5.2 插件明明装着
输入:
curl -s -u "$AUTH" "$ES/_cat/plugins?v"
输出(截取关键行):
name        component                     version
es-data-0   opendistro-index-management   1.x.x.0   ← ISM 索引管理,装了!
es-data-0   opendistro-security           1.x.x.0
es-data-0   repository-s3                 7.x.2
【解读】 插件在、接口却报错 → 大概率路径拼写或代理挡路。换路子:翻 Kibana Dev Tools 的历史查询记录,看前任运维留下的足迹。
5.3 前任的足迹,破案
GET /_opendistro/_ism/policies/fw_policy        ← 有个叫 fw_policy 的自动清理策略!
GET /_opendistro/_ism/explain/fw_session-2026.01.11
【解读】 两条线索:策略确实存在,叫 fw_policy;前任用的路径是 _opendistro/_ism,比 5.1 试的多个下划线——404 的原因大概率就在这。
5.4 拿到策略原文
在 Kibana Dev Tools 里执行(内网直连,不受代理影响):
GET /_opendistro/_ism/policies/fw_policy
输出(节选):
{
  "policy_id" : "fw_policy",
  "default_state" : "save_time",
  "states" : [
    { "name": "save_time",
      "transitions": [ { "state_name": "index_delete",
                         "conditions": { "min_index_age": "180d" } } ] },   ← 满 180 天
    { "name": "index_delete",
      "actions":  [ { "delete": {} } ] }                                    ← 整索引删除
  ],
  "ism_template" : { "index_patterns": [ "fw_acl-*", "fw_flow-*", "fw_session-*", "fw_cpl_acl-*" ] }
}
【解读】 四类防火墙日志,索引满 180 天自动删,新建索引自动纳入管理,2023 年 10 月起就存在。
顺手对个账:
数据窗口:2026.03.23 ~ 2026.09.18 = 179 天 ≈ 保留期 180 天   ✓
日均增量:1272GB ÷ 179 天 ≈ 7.1 GB/天                        ✓
对账:180 天 × 7.1 ≈ 1273GB ≈ 实际用量 1272GB                ✓
每天进多少、删多少,完美稳态。账面对得这么齐,我一度以为结案了。
转折:一夜翻倍的日增量
"稳态"是拿总量÷天数算的,这是窗口平均值。第二天补了一个动作:按天拆开,看最近 30 天每天进多少。
输入:
curl -s -u "$AUTH" "$ES/_cat/indices?h=index,store.size" \
| awk '{
    if ($1 !~ /^fw/) next;                    # 只统计 fw_* 日志
    d=$1; sub(/^[^-]+-/,"",d);                # 从索引名抠出日期
    if (d >= "2026.08.19") {
      sz=$2; val=sz+0; u=sz; sub(/^[0-9.]+/,"",u);
      m=(u=="pb")?1125899906842624:(u=="tb")?1099511627776:(u=="gb")?1073741824:(u=="mb")?1048576:1;
      sum[d]+=val*m;
    }
  } END{for(x in sum) printf "%s  %8.2f gb\n", x, sum[x]/1073741824}' | sort
命令有点长,不用看懂每一段,直接抄:把所有
fw_*索引按天汇总落盘大小。
输出(按趋势分段):
2026.08.19 ~ 2026.09.08(21 天):6.33 ~ 8.14 gb/天,均值 ≈ 7.4    ← 平稳
2026.09.09                      :14.74 gb                        ← 一夜翻倍
2026.09.09 ~ 2026.09.17(9 天) :14.44 ~ 15.44 gb/天,均值 ≈ 14.9  ← 翻倍后走平
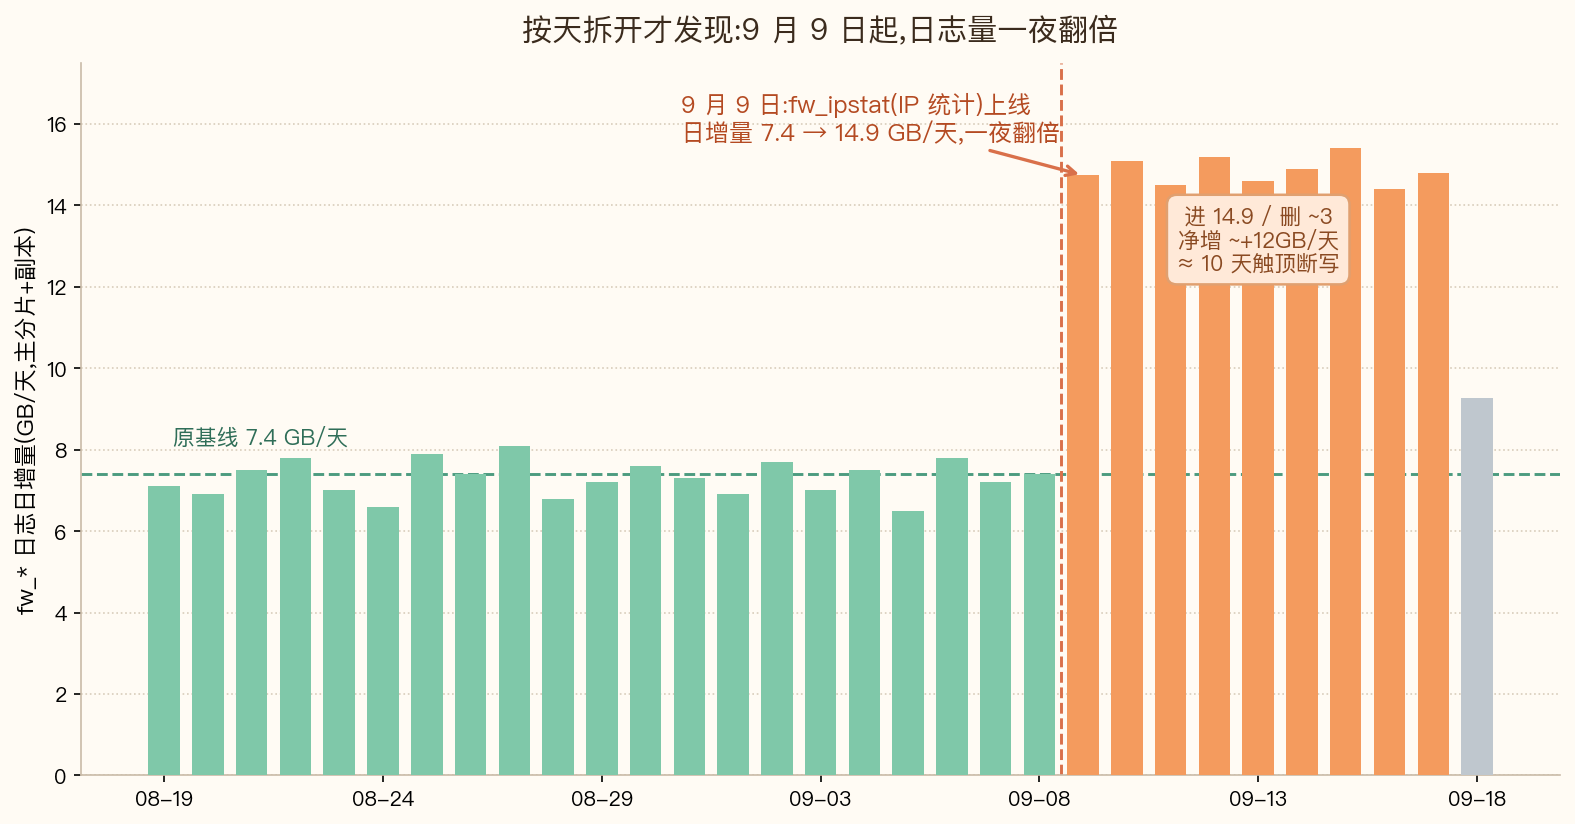
业务自然增长不会是隔夜翻倍的台阶,台阶只属于变更。逐日志家族一对:
09.06~09.08(每天 3 个):fw_session 7.7~7.9gb | fw_flow ~118mb | fw_acl ~20mb
09.09~09.12(每天 4 个):fw_session 7.7~8.0gb | fw_flow ~119mb | fw_acl ~20mb | fw_ipstat 6.7gb ← 新面孔
【解读】 9 月 9 日起多了一个全新日志家族 fw_ipstat-*(IP 统计),每天 6.7GB——产品侧新功能上线的写入量,日增量恰好翻倍(7.4 → 14.9,2.02 倍)。
这里有个容易冤枉人的地方:新家族自带 10 天短保留策略,到期就删,托管闭环,稳态只占约 67GB,它不背"无限累积"的锅。
真正的账是这样的:ISM 每天删的,是 180 天前(3 月下旬)的老索引,那年头一天才 1~3GB;而每天新进 14.9GB。进的多、删的少,集群净增约 +12GB/天。
距 95% 断写线约 128GB,除以 12 ≈ 10 天。
"总量÷天数"这笔铁账,差点把增长趋势骗过去。窗口平均数会骗人,按天序列不会。
根因,两句话说完
盘本来就配小了:180 天保留 × 8GB/天,加上 IP 统计的稳态,长期需求约 1.51TB,总容量只有 1.47TB——就算没有新功能,这盘也是贴顶运行。
9 月 9 日新功能让日增量翻倍,把"贴顶"变成"倒计时"。
处置也干脆:和产品侧确认 IP 统计属规划内功能、清理策略托管正常,数据盘按需扩容,当天完成。扩容后存储 50.9%,红色过载恢复蓝色正常,集群 green,90% 告警从此不会再触发。
这次排查沉淀的 8 条经验
- 告警字段是第一现场:挂载路径直接给出 POD UID 和 PVC ID,路线图藏在报错里;
- 生产排查,只读先行:df / du / lsof / curl GET,全程不做任何变更;
- 先排除"删除未释放":
lsof +L1,磁盘告警的头号惯犯; - 目录结构会自报家门:
nodes/0/indices/一眼 ES; - 窗口平均会骗人:稳态结论必须落到按天序列上验证;
- 隔夜翻倍 = 有变更:去问产品、问发布,别硬猜;
- 动密码前想想谁在用:服务正拿这个账号写日志,重置密码等于亲手断写;排查完顺手清一下 shell history;
- 顺带发现:监控规则的正则把设备名 nbd 写成了 ndb,排除条件形同虚设——已提规则变更单。
磁盘告警排查的尽头,往往不是"谁把盘搞坏了",而是"业务长了,盘子没跟上"。
小白术语表
| 术语 | 一句话解释 |
|---|---|
| nbd | 网络块设备,通过网线"插"到服务器上的云盘 |
| PV / PVC | PV=真实的盘;PVC=容器对盘的"申请单" |
| 索引(Index) | ES 里的一张"表",本例按天建:fw_session-2026.09.18 就是 18 号那天的会话日志 |
| 分片(Shard) | 索引的"分身",把大表切开存到不同节点 |
| ISM | Open Distro 的索引自动管理:按策略自动删除过期索引 |
| 三道水位 | ES 的磁盘防线:85% 不进新数据 → 90% 开始搬迁 → 95% 只读断写 |
| 稳态 | 每天新增 = 每天删除,总量不涨 |
| 净增长 | 每天新增 > 每天删除,总量持续上涨(本例约 +12GB/天) |
🎯 老张建议
- 托管服务也要算"水位预算":保留策略 × 日增量的乘积,别超过总容量的 80%,超了就扩,别等告警;
- 排查结论要"对账",更要"看趋势",文末那条按天聚合的 awk,建议直接收进工具箱;
- 新功能上线的评审单里,加一列:它每天往哪写多少数据、保留多久。
💬 互动话题
- 你遇到过"集群全绿但就是快满了"的告警吗?最后查出什么?
- 日志保留期,你们定多少天?谁拍的板?
- 有没有哪次"对账全对、结论全错"的经历?
🔗 关注老张
公众号:老张聊运维 小程序:观简国学 个人博客:https://www.shanwaiyun.top/