DeepSeek V4.1 Flash 发布:V4 Pro 全量切流,flash 系列全线降价
DeepSeek 今天两件大事:V4.1 Flash 正式发布,官方称各项指标全面超越 V4 Pro,Pro 的请求全部切到它身上、按 Flash 价格计费;同时 flash 系列全线降价,缓存命中价直接砍了 60%。
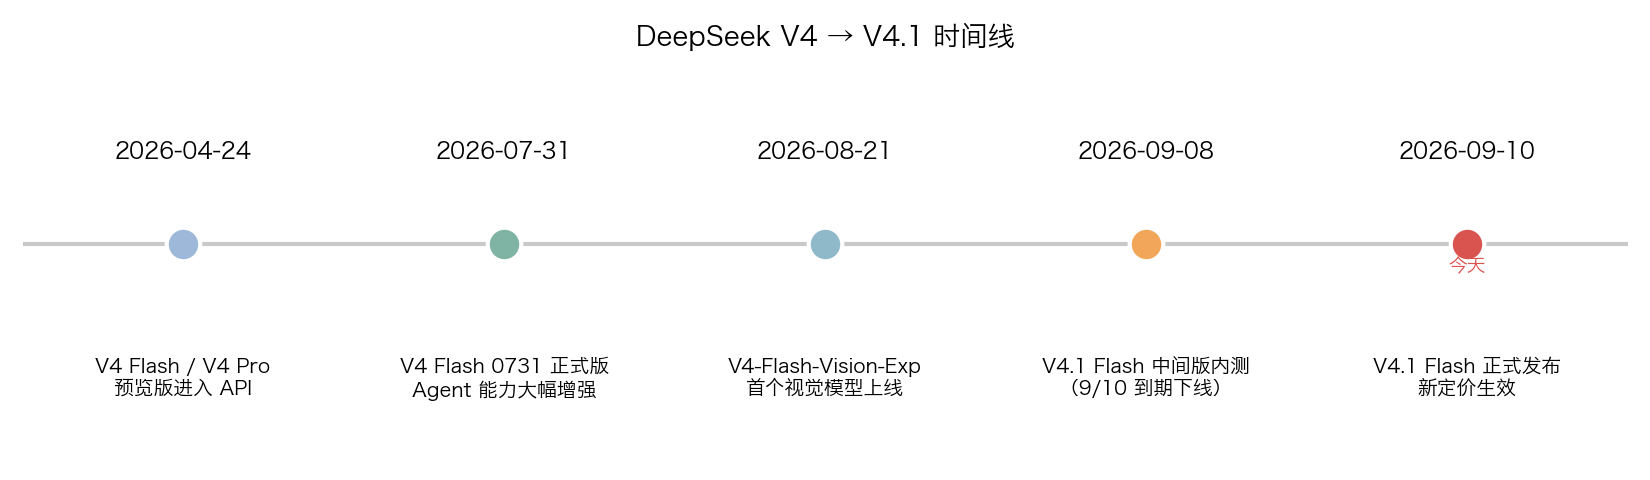
老张今天上午打开 DeepSeek 开放平台后台,用量信息页连着弹了两条蓝条公告。顶部还挂着一条多模态视觉模型的横幅——注意,那个不是今天的新闻,V4-Flash-Vision-Exp 是 8 月 21 日就上线的,横幅只是还没撤。真正的今天主角是 V4.1 Flash 和新定价。
速览表
| 事项 | 内容 | 生效时间 |
|---|---|---|
| V4.1 Flash 发布 | 官方称性能、费用、速度、总用时全面超越 V4 Pro | 9 月 10 日前后 |
| V4 Pro 全量切流 | Pro 请求路由到 V4.1 Flash,按 Flash 单价计费 | V4.1 Flash 上线后 |
| flash 系列降价 | 缓存命中 0.02 元(-60%),未命中 1 元(-33%),输出 4 元(-11%) | 9 月 10 日 12:00 |
发生了什么
公告原文是这么写的:V4.1 Flash 经内部、外部多方测试,在性能、费用、速度、总用时等各项指标上已全面超越 V4 Pro。
然后是关键操作——在 V4.1 Flash 正式上线之后、V4.1 Pro 上线之前,V4 Pro 的请求会全部路由到 V4.1 Flash,按 V4.1 Flash 的单价计费。
翻译成人话:Pro 用户花 Flash 的钱,用一个官方认证比 Pro 更强的模型。
这不是 DeepSeek 第一次干这种事。7 月 31 日的 V4 Flash 0731 正式版就是同样路数:架构和参数没变,只重做后训练,Terminal Bench 2.1 从 61.8 干到 82.7,DeepSWE 从 7.3 飙到 54.4,直接反超 V4 Pro 预览版。
这次的 V4.1 Flash 更进一步。9 月 8 日官方交流群开了中间版内测,模型 ID 叫 deepseek-v4.1-flash-expires-on-0910,9 月 10 日到期下线。全新模型结构,原生支持多模态,每账号限 20 并发,计费沿用 V4 Flash。内测问卷里官方直接问:这个版本能不能全面替代线上的 V4 Pro。
价格:不是涨,是全降
9 月 10 日 12:00 起的新定价(每百万 tokens):空闲时段缓存命中 0.02 元、缓存未命中 1 元、输出 4 元;高峰时段是空闲的 2 倍。
对比调整前的价格——空闲时段 0.05 / 1.5 / 4.5 元,高峰 0.1 / 3 / 9 元——三项全降:
- 缓存命中输入:0.05 → 0.02 元,降 60%
- 缓存未命中输入:1.5 → 1 元,降 33%
- 输出:4.5 → 4 元,降 11%
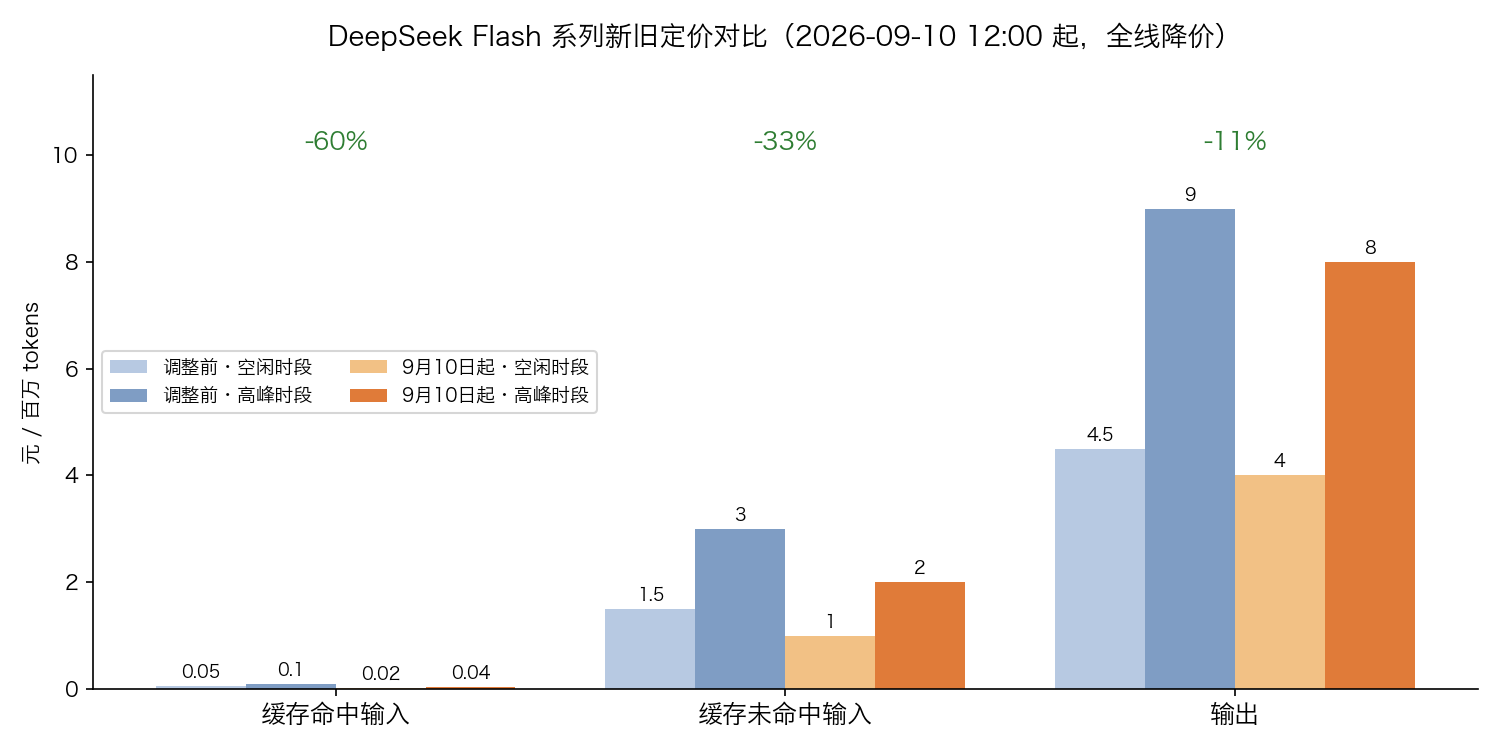
降得最狠的是缓存命中价。0.02 元,这是明牌鼓励你把 Prompt 缓存用起来。
Pro 用户更划算。Pro 原价输出 6 元、未命中输入 3 元,切流后按 Flash 新价算是 4 元和 1 元,还白捡一个官方认证更强的模型。
多模态这条线,串起来了
后台顶部那条横幅再拿出来说说。V4-Flash-Vision-Exp 是 8 月 21 日上线的实验性视觉模型,模型名 deepseek-v4-flash-vision-exp,支持 Chat Completions、Messages、Responses 三种格式,图片按 token 计费、单张封顶 384 tokens,官方口径是多模态 Agent 能力接近 Opus 4.8。
当时它更像「给文本模型加个视觉外挂」——DeepSeek 自己的资料也把 Vision-Exp 描述为「文本模型+外部视觉通路」。而 V4.1 Flash 的官方口径是原生支持多模态——新模型结构,图文由基础模型本身处理。
这个口径要打个问号吗?来源是 9 月 8 日官方交流群的内测通知原文,腾讯科技、澎湃、IT之家多家媒体引用的是同一来源,口径本身成立。但截至发稿,DeepSeek 官网、API 文档、Change Log 都没有 V4.1 Flash 的正式记录,没有技术报告、参数规模和 benchmark。实测能确认的模态只有「文本+图像」,音频、视频不在已确认范围。「原生」到什么程度,等正式版模型卡。
从 8 月 21 日的视觉实验版,到 9 月 8 日的 V4.1 内测,再到今天的正式发布,DeepSeek 补多模态这条线的节奏很清晰。
DeepSeek V4.1 Flash和 GLM-5.3-Flash 比呢
同为近期更新的国产 Flash 级模型,智谱的 GLM-5.3-Flash 是最直接的对手。我翻了智谱官方文档,数据摆一起:
| 维度 | DeepSeek flash 系列(9/10 新价) | GLM-5.3-Flash |
|---|---|---|
| 参数 / 架构 | 未公布(新模型结构) | 320B 总参 / 18B 激活,稀疏+线性注意力混合架构,开源 |
| 上下文 / 最大输出 | 未公布(V4 系为 1M / 384K) | 1M / 128K |
| 输入模态 | 官方称原生多模态,实测确认图文 | 视频、图像、文本、文件(支持视频) |
| 输入(缓存未命中) | 空闲 1 元 / 高峰 2 元 | 0.8 元,无峰谷 |
| 输出 | 空闲 4 元 / 高峰 8 元 | 2.8 元 |
| 缓存命中 | 0.02 元 | 0.23 元(缓存存储限时免费) |
两边的算盘不一样。GLM-5.3-Flash 未命中输入和输出都更便宜,支持视频输入,还开源可自建;DeepSeek 的杀手锏是缓存命中 0.02 元,比 GLM 的命中价便宜 10 倍以上。
缓存命中率高的业务选 DeepSeek,命中率低、输出量大、要看视频的业务选 GLM。性能上暂时没法硬比——V4.1 Flash 没公布任何 benchmark,两边手上都只有各自的官方口径。
对普通开发者的影响
如果你在用 V4 Pro:什么都不用改,请求自动路由,账单自动变便宜。留意输出行为和旧 Pro 的差异,官方也提醒发现问题及时反馈。
如果你在用 V4 Flash:账单只会变薄不会变厚。输出占比高的业务省 11%,缓存命中率高的业务省得更多。
如果你在做 Agent / 编程工具:V4 Flash 0731 已经原生支持 Responses API、适配 Codex,V4.1 Flash 只会更顺。模型 ID 是否沿用现有名称,等正式文档确认。
老张判断
DeepSeek 这套打法已经清楚了:小参数模型 + 重后训练,越级打分,然后用价格差碾压。V4.1 Flash 全面超 V4 Pro 是官方说法,具体成色等第三方实测,但参考 0731 那次的历史,大概率不是吹的。
更值得琢磨的是降价的结构。输出只降 11%,缓存命中直接砍 60%。**推理成本的大头在生成侧,这已经是定价层面的官方实锤。**以后「让模型少废话」和「让缓存多命中」,都是真金白银。
另外留意一个背景:同一天有媒体曝出 DeepSeek 已聘请中信证券筹备科创板 IPO。降价抢开发者,资本市场讲故事,两条线一起看更有意思。
🎯 老张建议
- Pro 用户今天就可以去对账:切流后按 Flash 新价计费,输入输出双降。
- 立刻检查 Prompt 缓存命中率:0.02 元是全表降幅最大的数字,缓存友好化改造现在 ROI 最高。
- 多模态场景再等一等:Vision-Exp 是实验版,V4.1 Flash 才是原生多模态的主力,新项目直接上 V4.1。
💬 互动话题
- 你的业务缓存命中率多少?这波 60% 的降幅能吃到多少?
- V4.1 Flash 全面超 V4 Pro,你信官方口径还是等第三方实测?
- DeepSeek 如果真上科创板,你会打新吗?
🔗 关注老张
公众号:老张聊运维 小程序:观简国学 个人博客:https://www.shanwaiyun.top/