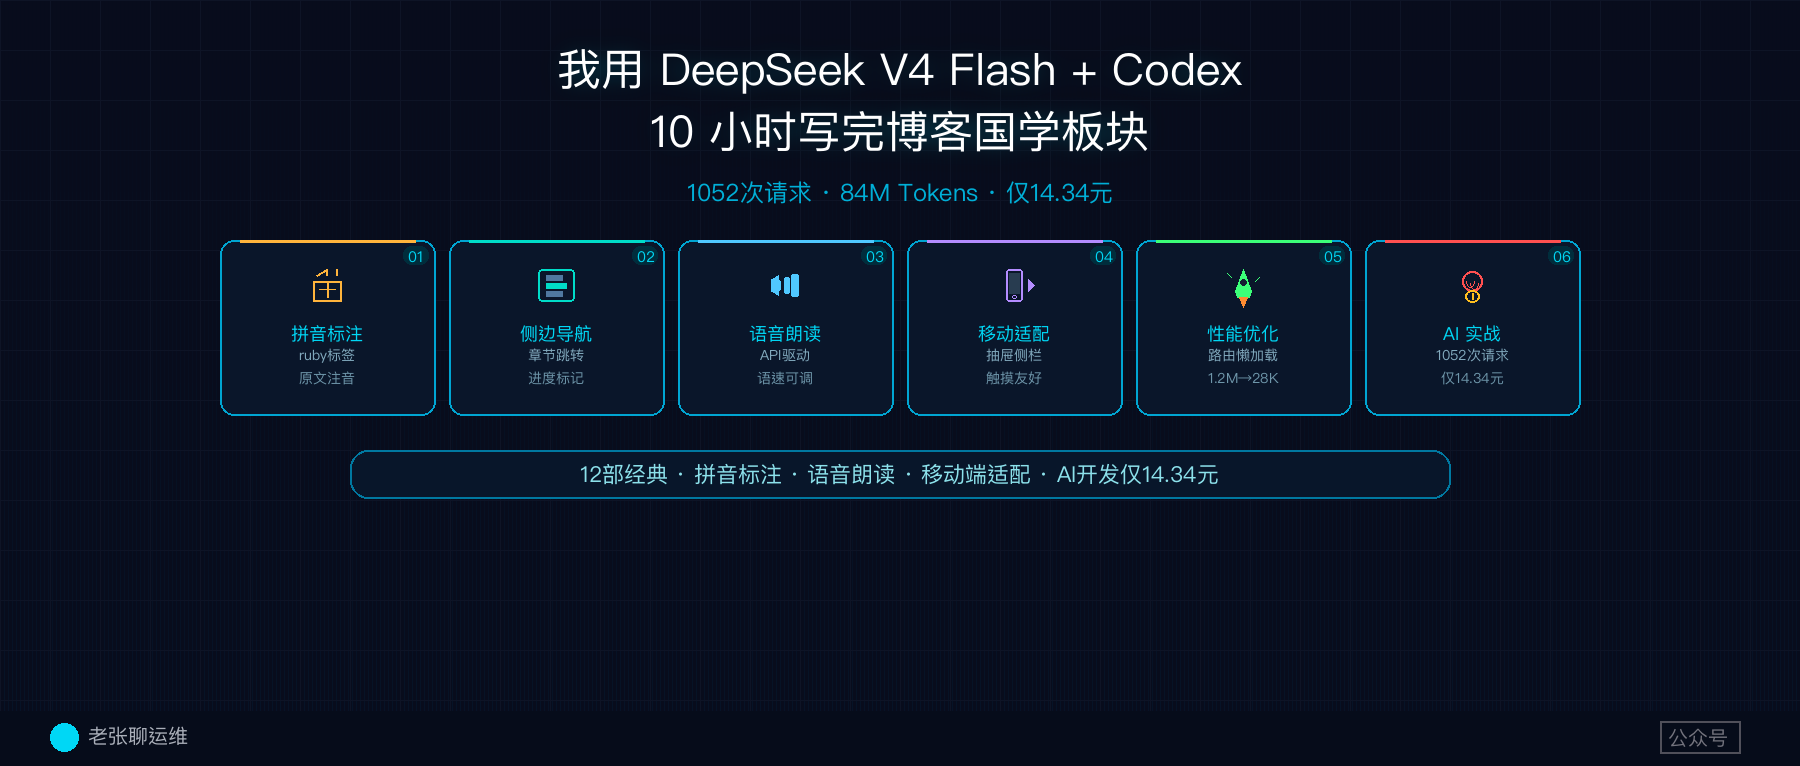
我用 DeepSeek v4 Flash + Codex,10 小时写完博客国学板块(花了 14.34 元)
说个巧合的事:
昨天我刚写了一篇《DeepSeek v4 正式版来了!原生支持 Codex》,说 DeepSeek 不用中转,直接支持 ChatGPT 桌面端的 Codex 功能。
今天,我就用 DeepSeek v4 flash + Codex,实战开发了一整个国学板块。
从早上 9 点到晚上 7 点,10 个小时,17 次 git commit,把书架页、阅读器、侧边栏、拼音标注、语音朗读、移动端适配、性能优化,一口气全部搞定。
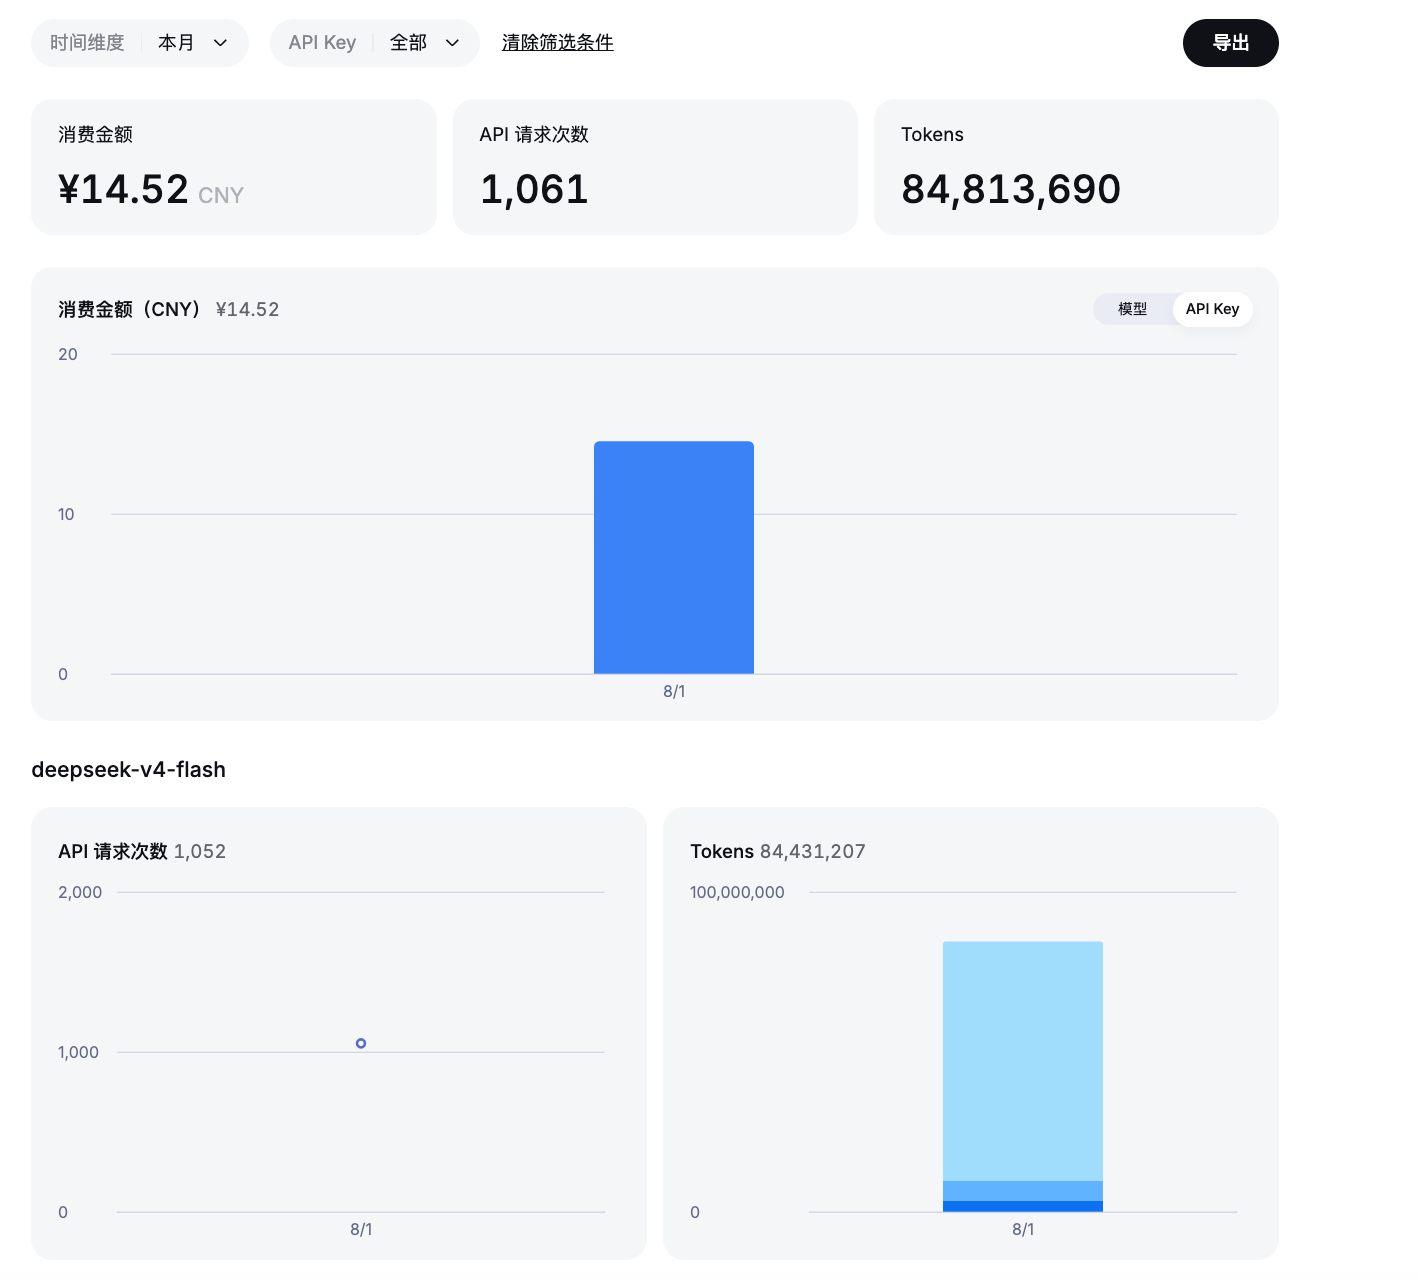
更巧的是,DeepSeek 控制台显示:1052 次 API 请求,84,431,207 Tokens,消费 14.34 元。
这篇文章我会从两个角度写:
- 普通读者:看看国学板块有什么功能,怎么用
- 开发者朋友:看看我是怎么用 AI 辅助开发的,真实成本是多少
先说说背景:为什么要做这个板块?
读国学经典,你大概率遇到过这几个痛点:
- 读音不准:有些生僻字、通假字,读错了意思就偏了
- 注释麻烦:原文、译文、注释分开,来回翻页太费劲
- 进度难记:上次读到第几章第几节,经常要找半天
- 手机阅读体验差:网页字太小,侧边栏占地方
- 想"听"国学:通勤、做家务的时候想听,但找不到合适的朗读
之前,想解决这些问题,你得装好几个 APP:一个查读音、一个做笔记、一个用来听书。
折腾过的同学都懂——APP 之间数据不通,进度要同步,格式要转,虽然能用,但总觉得像在"打补丁",心里不踏实。
现在好了,山外云博客直接把这些功能全做进去了。
什么叫"沉浸式阅读体验"?
意思是:
- ❌ 不需要 装多个 APP
- ❌ 不需要 来回切换查字典
- ❌ 不需要 自己做进度标记
✅ 打开网页就能读,拼音、译文、注释、朗读、目录,一应俱全
体验下来:
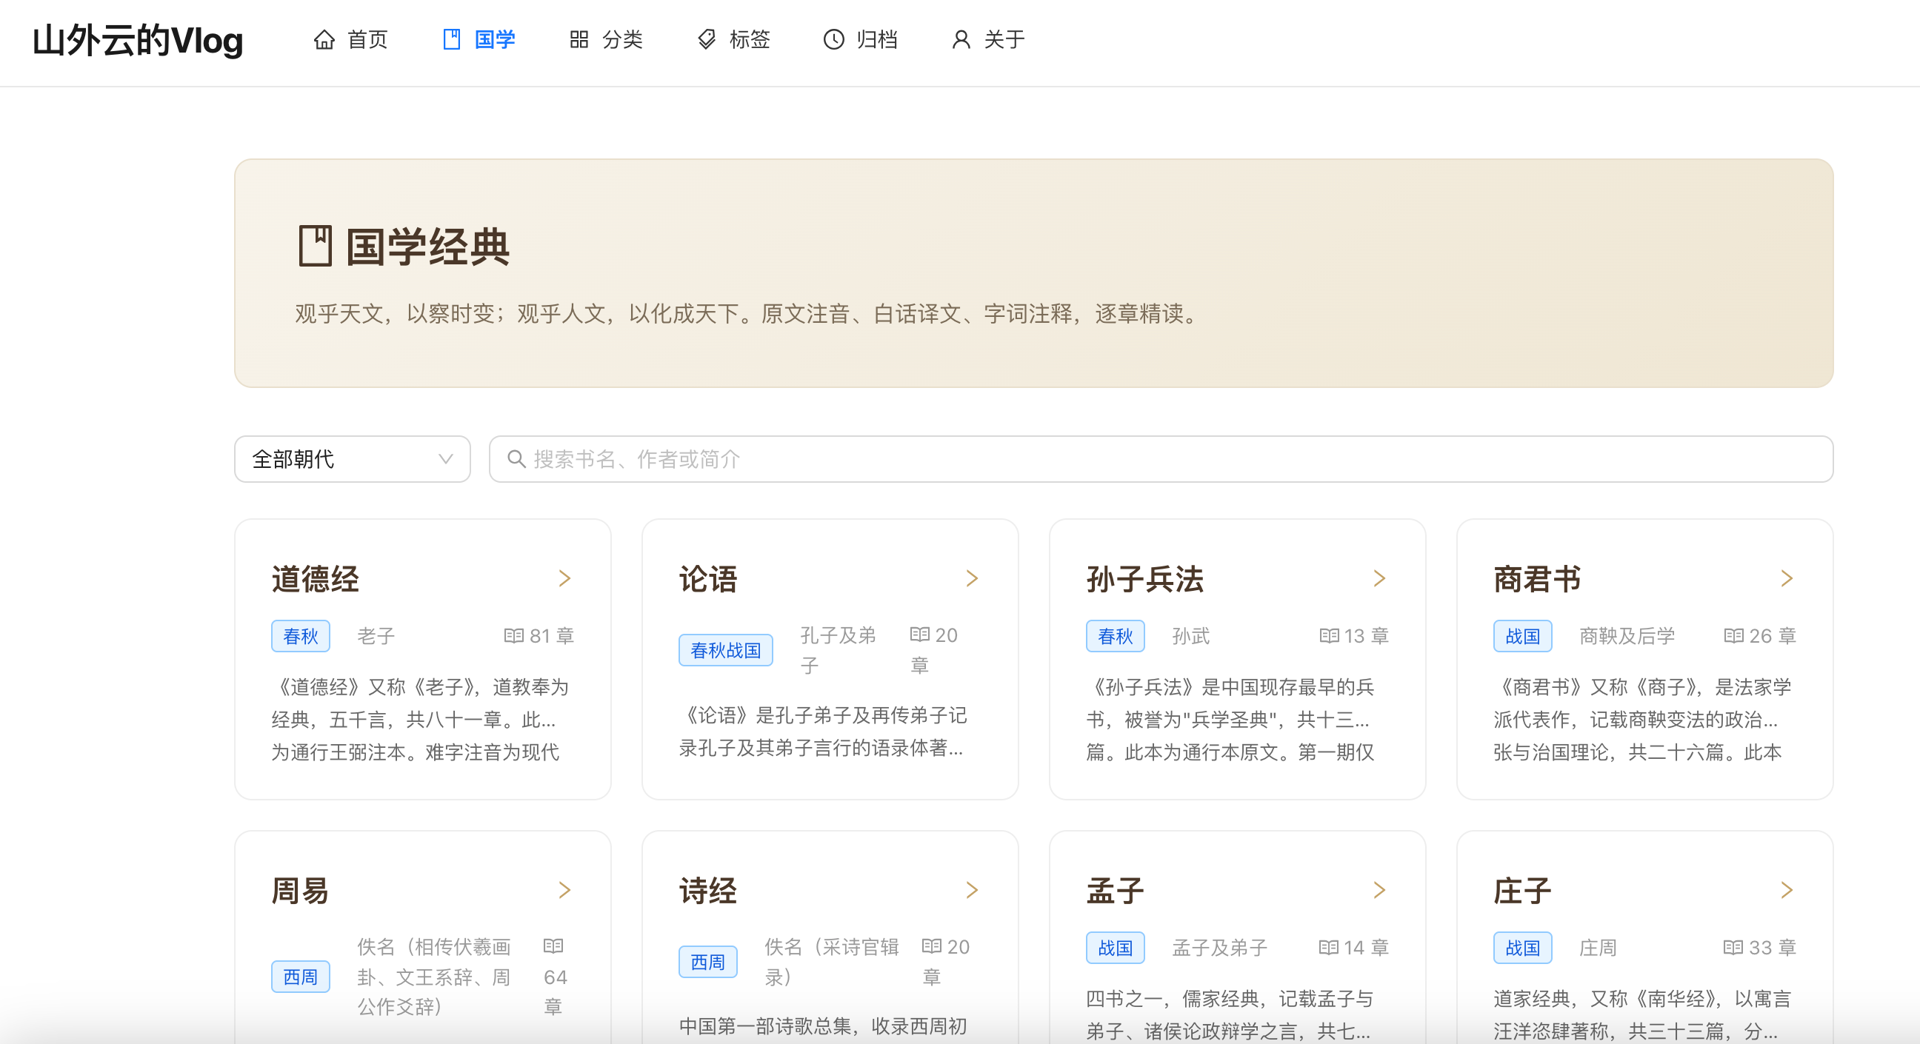
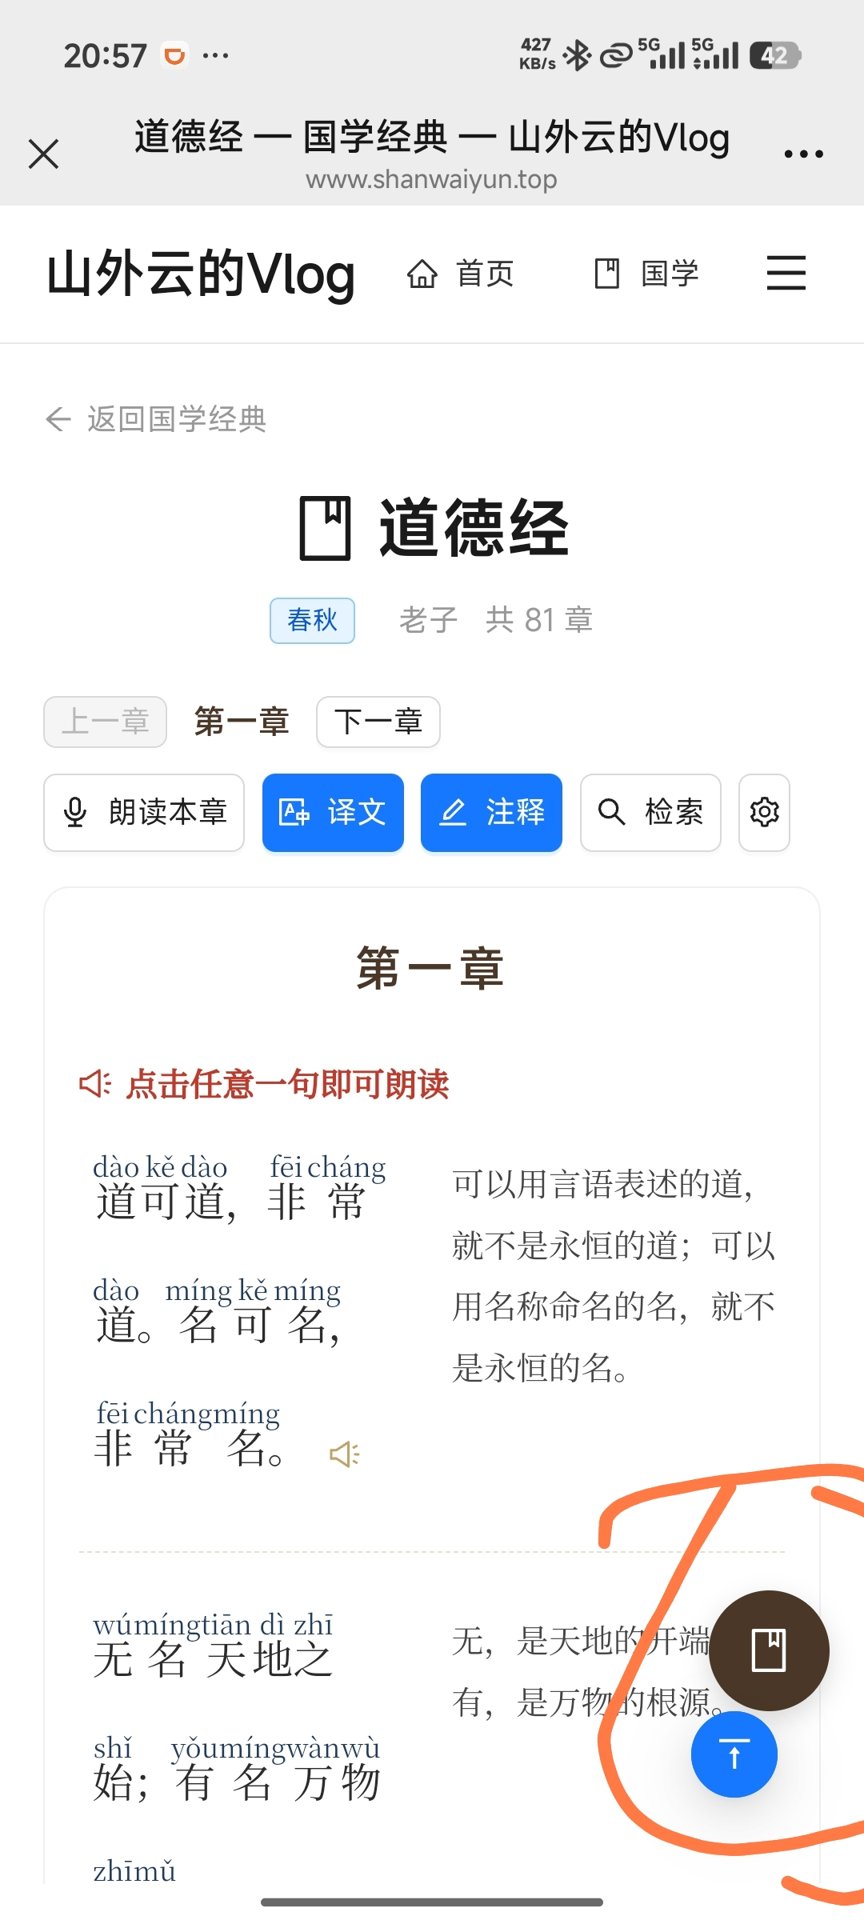
- 书架页:典籍按学派分类,封面+简介一目了然
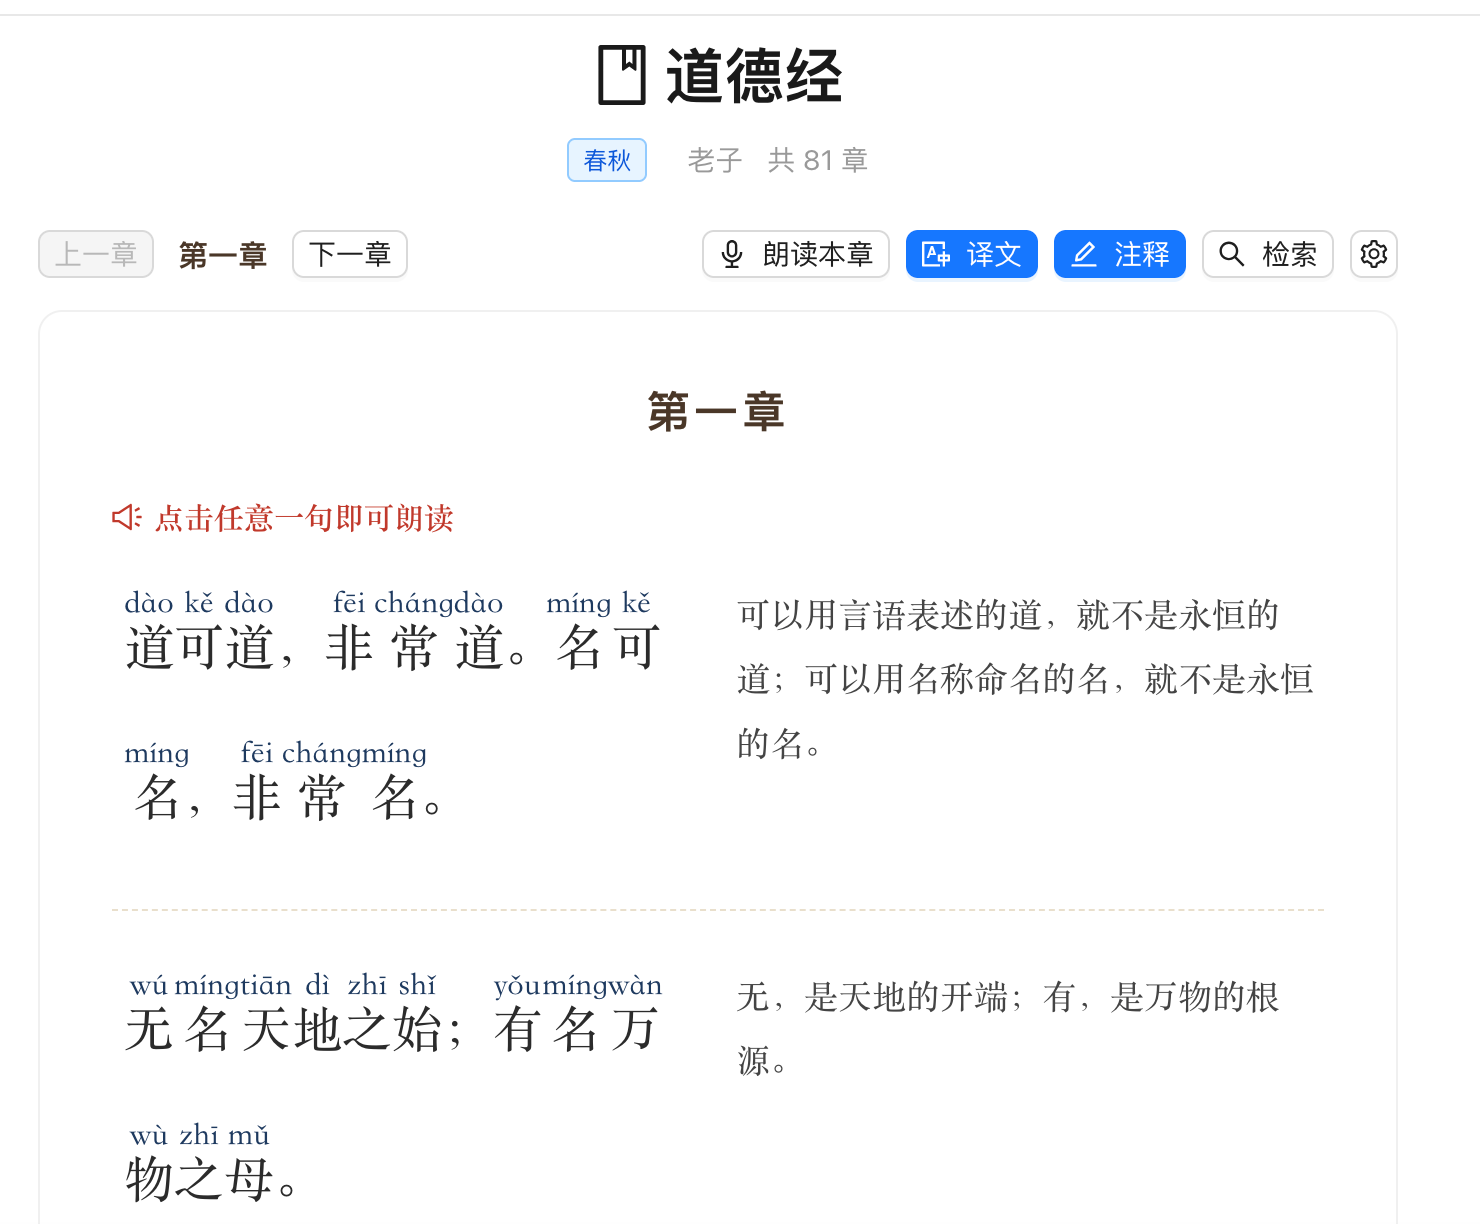
- 阅读页:原文带拼音,译文、注释折叠展开,想看就看
- 侧边栏:章节目录置顶,点击跳转,阅读进度自动保存
- 工具箱:朗读、检索、主题切换、折叠译文,一键操作
- 移动端:抽屉式侧边栏,不占阅读空间,触摸友好
界面还是你熟悉的博客风格,背后多了一整套国学阅读的基础设施。
实操:打开就能用,30 秒上手
我自己刷了好几遍,从首页到读完《道德经》第一章,全程不到 30 秒。
步骤 1:进入国学板块
首页导航栏点「国学」,直接进入书架页:
首页 → 国学 → 选择你想读的典籍
12 部经典,按学派分好了:
- 道家:道德经、庄子、列子
- 儒家:论语、孟子、大学、中庸
- 法家:商君书、韩非子
- 兵家:孙子兵法
- 纵横家:鬼谷子
每部典籍都有封面、作者、朝代、简介,想读哪部点哪部。
步骤 2:侧边栏导航
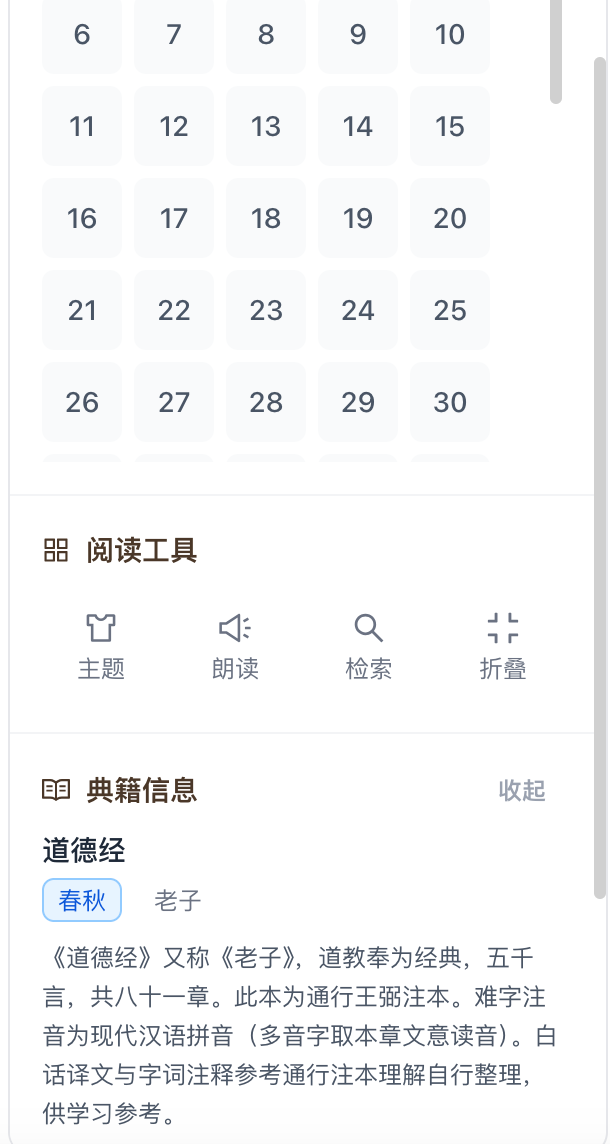
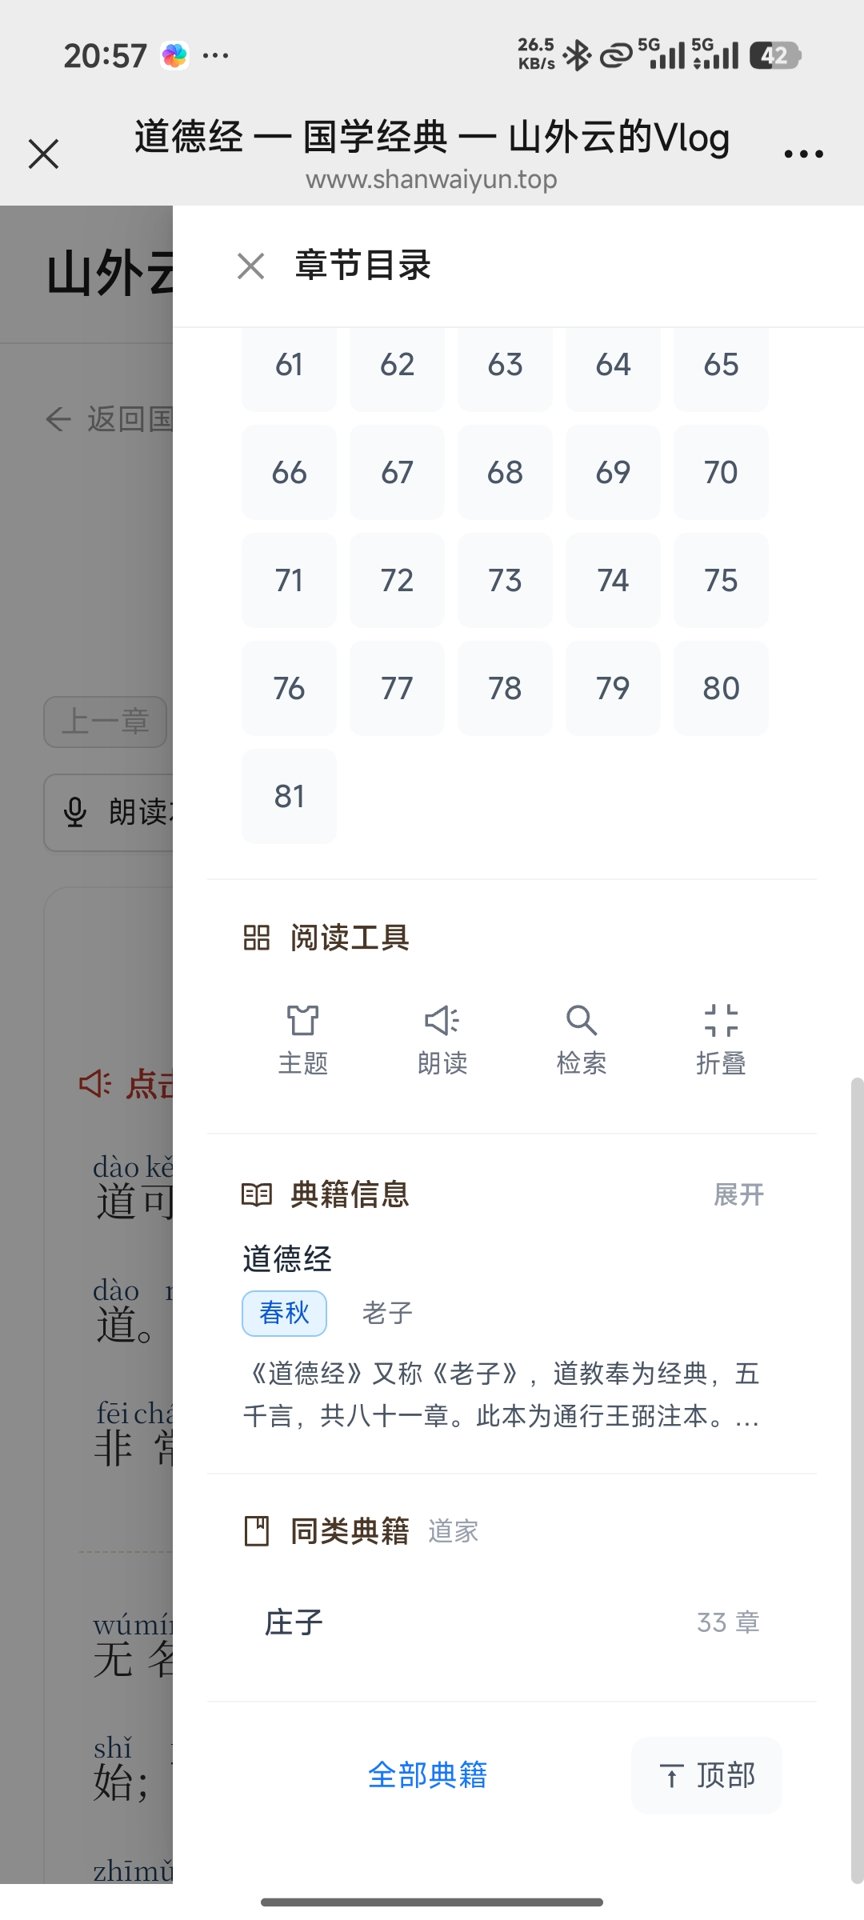
打开典籍后,右边侧边栏(移动端是抽屉)就是章节目录:
第 1 章 第 2 章 第 3 章 ...
点击章节号,直接跳转到对应章节。上次读到第几章,小圆点自动标记,下次打开直接继续。
侧边栏中间是「阅读工具」:
- 🔊 朗读:点击开始朗读当前章节
- 🔍 检索:全文检索关键词
- 🎨 主题:切换浅色/深色模式
- 📄 折叠:一键折叠所有译文/注释
最下面是「典籍信息」,作者、朝代、简介都有,还能展开看详细介绍。
步骤 3:语音朗读
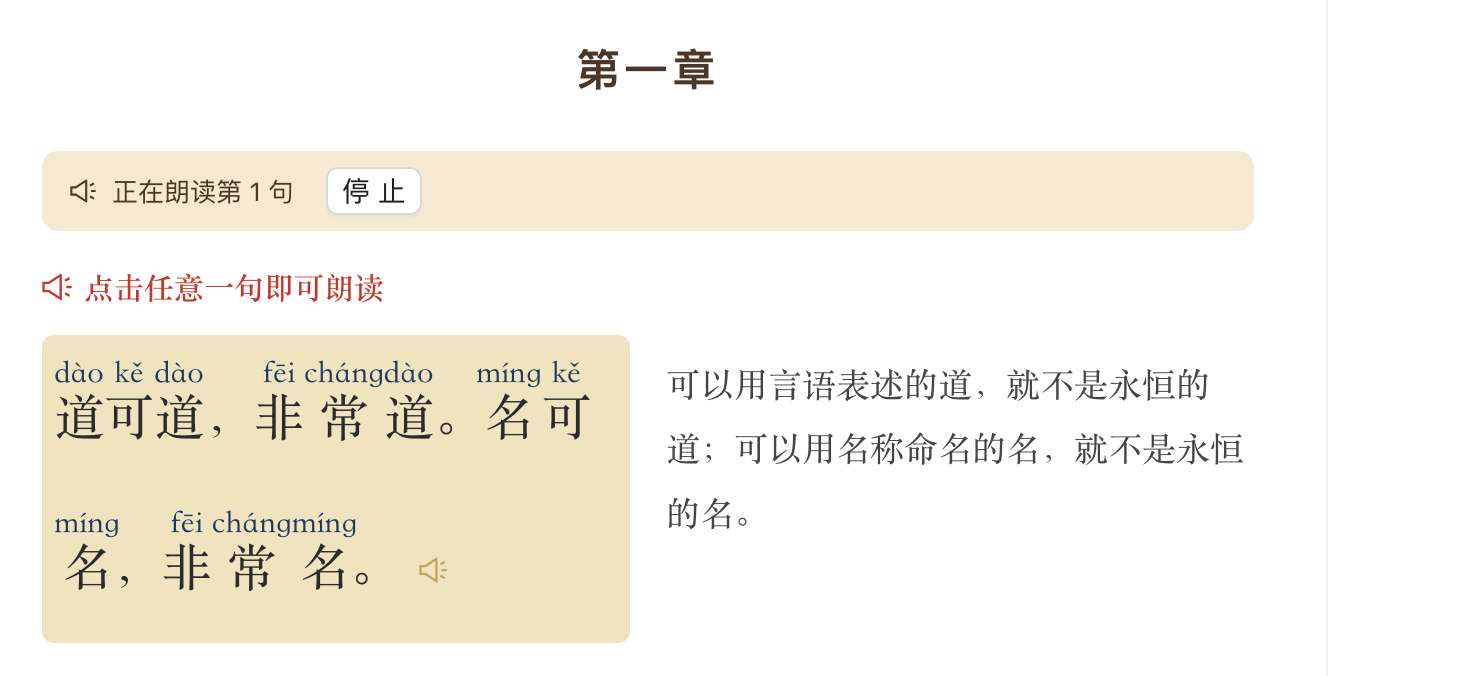
点击侧边栏的「朗读」按钮,直接开始读:
道可道,非常道。名可名,非常名...
朗读自动按句号切分,读完一句自动下一句,高亮当前正在读的句子。
- 支持选择不同的系统语音
- 支持调节语速(0.7x ~ 1.3x)
- 支持点击任意句子开始读
- 移动端专门做了兼容性优化,Android Chrome 也能正常用
实际用下来怎么样?
用了几小时,说几个真实感受:
✅ 拼音标注真的有用
之前读《道德经》,有些字确实拿不准读音,比如「夫唯不居,是以不去」的「夫」应该读二声还是一声,现在直接标在上面,一目了然。
用 ruby 标签做的,拼音在字上方,不影响阅读流畅度。
✅ 连续朗读体验很好
做家务、通勤的时候,点开朗读就能一直听下去,不用手动操作。语速可以调,我自己习惯用 0.9x,听得清楚也不拖沓。
✅ 上次阅读标记很贴心
打开典籍直接看到上次读到第几章,不用回忆「我上次看到第几章来着?」,点一下就继续了。
⚠️ 目前朗读只支持中文
英文内容朗读效果一般,但读国学完全够用了。
毕竟咱们读的是中文经典,这个问题影响不大。
🛠️ 技术干货:DeepSeek v4 Flash + Codex 实战开发
这部分是写给开发者朋友的,普通读者可以跳过。
先说结论:DeepSeek v4 flash + Codex,10 小时,14.34 元,开发完一个完整功能模块。
开发方式:全流程 AI 辅助
我的开发流程是这样的:
- 需求梳理:告诉 AI 我要做什么,让它给方案
- 代码编写:ChatGPT 桌面端(Codex)直接写代码,写完复制到 VS Code
- 调试修复:出了 bug,把报错信息贴给 AI,让它改
- 优化迭代:哪里体验不好,告诉 AI,让它优化
全程 1052 次 API 请求,平均每小时 100 多次,基本是想到就问,问完就写,写完就试。
技术栈
- 前端:React 18 + TypeScript
- 样式:Tailwind CSS (侧边栏重构从 0 到 1 全是 AI 写的)
- UI 组件:Ant Design
- 后端 API:FastAPI
- 数据库:PG
- AI 工具:ChatGPT 桌面端 + DeepSeek v4 flash(原生 Codex 支持)
一天开发时间线
| 时间 | 提交 | 内容 |
|---|---|---|
| 上午 | 1db5fa7 | 国学板块基础功能:典籍数据、书架页、阅读页 |
| 中午 | 61b1d4c | 前端打磨:布局拆分、680px 容器、拼音弱化、区块隔离 |
| 下午 | f5dbd03 | 后台编辑器优化:折叠栏、快捷键、字数统计、SEO、自动保存 |
| 傍晚 | 4750089 → 9e349ca | 移动端:顶部导航、汉堡菜单、侧边栏快捷操作 |
| 晚上 | 5e24351 → 3e61d43 | 侧边栏 5 步优化:删重复、去网格、合并卡片、工具箱、折叠信息 + 修复 TDZ 死链 |
| 深夜 | ecaee69 → 4ac15e7 | 性能优化、抽屉侧边栏、Android Chrome 朗读兼容性 |
几个有意思的技术难点和 AI 解决方案
1. 拼音标注:AI 建议用 HTML ruby 标签
最开始我想过用图片、或者 CSS 伪元素。
AI 直接告诉我:用 HTML5 原生的 <ruby> 标签,语义化、可访问、无需额外 CSS。
<ruby> 道<rt>dào</rt> 可<rt>kě</rt> 道<rt>dào</rt></ruby>
渲染效果就是你看到的:字上面有拼音,原生支持,不需要任何 JS。
这就是 AI 的价值:你没想到的方案,它直接给你最优解。
问题 2:语音列表加载是异步的,直接 getVoices() 可能返回空数组
AI 给的解决方案:每次朗读前都检查,为空就延迟重试。
const voices = window.speechSynthesis.getVoices();if (voices.length === 0) { // 语音列表未加载,延迟重试 setTimeout(() => playAt(index), 100); return;}
问题 3:TDZ 死链(这个坑了我半小时)
事件监听器写在了 sentences 变量定义之前,导致"Cannot access 'sentences' before initialization"。
我把报错信息贴给 AI,3 秒钟就定位到了问题:代码顺序问题,先定义数据,再绑定事件。
AI 找 bug 的速度,比我自己快 10 倍。
3. 性能优化:从 1.2MB 到 28KB,路由懒加载 + 代码分割
优化前:首页加载把所有路由的代码都打包在一起,1.2MB。
我问 AI:"React 怎么优化首屏加载速度?"
AI 直接给出方案和代码:
// 路由懒加载const Guoxue = lazy(() => import('./pages/blog/Guoxue'));const GuoxueReader = lazy(() => import('./pages/blog/GuoxueReader'));// Suspense 包裹<Suspense fallback={<Spin size="large" />}> <Guoxue /></Suspense>
效果:首页加载体积 28KB,国学相关代码只有访问 /guoxue 时才加载。
4. 移动端抽屉式侧边栏
我:"侧边栏在手机上太占地方,体验不好"
AI 直接给出 CSS + React 的完整实现:
@media (max-width: 768px) { .guoxue-sidebar { position: fixed; right: -320px; top: 0; height: 100vh; transition: right 0.3s ease; } .guoxue-sidebar.open { right: 0; }}
配合 React state 控制 open 类,768px 以下自动隐藏侧边栏,点击悬浮按钮呼出抽屉。
📊 DeepSeek v4 Flash 实战成本分析
| 指标 | 数据 | 备注 |
|---|---|---|
| 开发时间 | 10 小时 | 从早上 9 点到晚上 7 点 |
| API 请求次数 | 1,052 次 | 平均每小时 105 次 |
| Tokens 消耗 | 84,431,207 | 8400 多万 tokens |
| 总消费 | 14.34 元 | 平均每小时 1.43 元 |
| 每 1M tokens 价格 | 0.17 元 | DeepSeek 是真的便宜 |
14 块钱,雇了一个 10 小时不吃不喝的高级程序员。
对比一下:如果找程序员做这么一个功能模块,少说也要上千块钱。
为什么我觉得这事儿值得做?
技术上不难,但意义上很不一样。
1. 传统文化的传播需要新的载体
经典之所以成为经典,是因为它们有价值。但怎么让现代人愿意读、读得进去,需要有人做一些「翻译」工作——不是翻译内容,而是翻译「阅读体验」。
把古籍从纸质书搬到网页,不是简单地把文字贴上去就完了。拼音、注释、朗读、检索、移动端适配,这些都是降低门槛的方式。
你不用买实体书、不用查字典、不用装 APP,只要打开网页,就能读。
这是非常朴素的想法:降低门槛,让更多人能接触到经典。
2. 对开发者的启发:AI 时代,一个人就是一支军队
很多人觉得"做产品"需要一个团队,需要后端、前端、产品、设计一起配合。
但这次国学板块的开发证明了:一个人,10 小时,14 块钱,也能做出一个完整的、体验不错的功能模块。
关键是:
- 需求明确(解决自己的痛点)
- 技术栈熟悉(不用花时间学新东西)
- 善用 AI 工具(DeepSeek v4 flash 真的好用)
- 迭代快速(想到就做,做好就上线)
3. DeepSeek Codex 原生支持是真的香
昨天刚写文章说 DeepSeek 原生支持 Codex,今天就实战验证了。
不需要中转工具、不需要改代理、不需要折腾配置,一键脚本 30 秒搞定,然后就可以埋头开发。
84M tokens,14.34 元,这个价格,这个体验,还要什么自行车?
几个常见问题
Q:典籍内容是从哪来的?准确吗?
A:内容整理自公开的古籍数据库,逐章校对过。如果发现错字,可以在评论区告诉我,我会及时修正。
Q:支持离线阅读吗?
A:目前是网页版,需要联网。后续可以考虑做 PWA 支持离线。
Q:朗读为什么有时候没声音?
A:如果是 Android Chrome,第一次使用需要先点击一下页面激活语音引擎,这个是浏览器的安全限制,我已经做了自动激活处理,正常点击朗读就能用。
Q:会加更多典籍吗?
A:会的。先把这 12 部打磨好,后续根据大家的需求逐步增加。
Q:AI 写的代码质量怎么样?
A:DeepSeek v4 flash 写的代码质量很高,变量命名、注释、代码结构都很规范。我基本就是复制粘贴,然后微调一下。
Q:代码开源吗?
A:目前还没有开源的计划,但文章里已经把核心技术点和代码片段都分享了,有兴趣的朋友可以参考。
总结一下
- 🔥 山外云博客国学板块正式上线,18 部经典完整收录
- ✅ 原文带拼音标注,ruby 标签实现,美观准确
- ✅ 侧边栏章节目录,点击跳转,上次阅读自动标记
- ✅ 语音朗读支持,可切换语音、调节语速,移动端专门优化
- ✅ 抽屉式侧边栏,移动端体验友好
- ✅ 性能优化:路由懒加载,首页 1.2MB → 28KB
- 🤖 DeepSeek v4 flash + Codex 实战:10 小时,1052 次请求,84M tokens,14.34 元
- ⏳ 后续还会加更多典籍和功能
完整功能 + 移动端优化 + 性能优化,这个国学板块我自己用着挺顺手。
如果你是普通读者,推荐现在就去试试,打开网页就能读,30 秒的事儿。
如果你是开发者,强烈建议你试试 DeepSeek v4 flash + Codex。14 块钱,就能让你体验"一个人就是一支军队"的开发效率。
🔗 阅读入口:https://www.shanwaiyun.top/guoxue
🔗 DeepSeek Codex 配置教程:(可以放昨天那篇文章的链接)
山外云的Vlog
关注我,分享编程、运维、AI 工具实战,以及有意思的技术探索。
你平时喜欢读哪部国学经典?对这个板块有什么建议?或者对 AI 辅助开发有什么想问的?评论区聊聊~