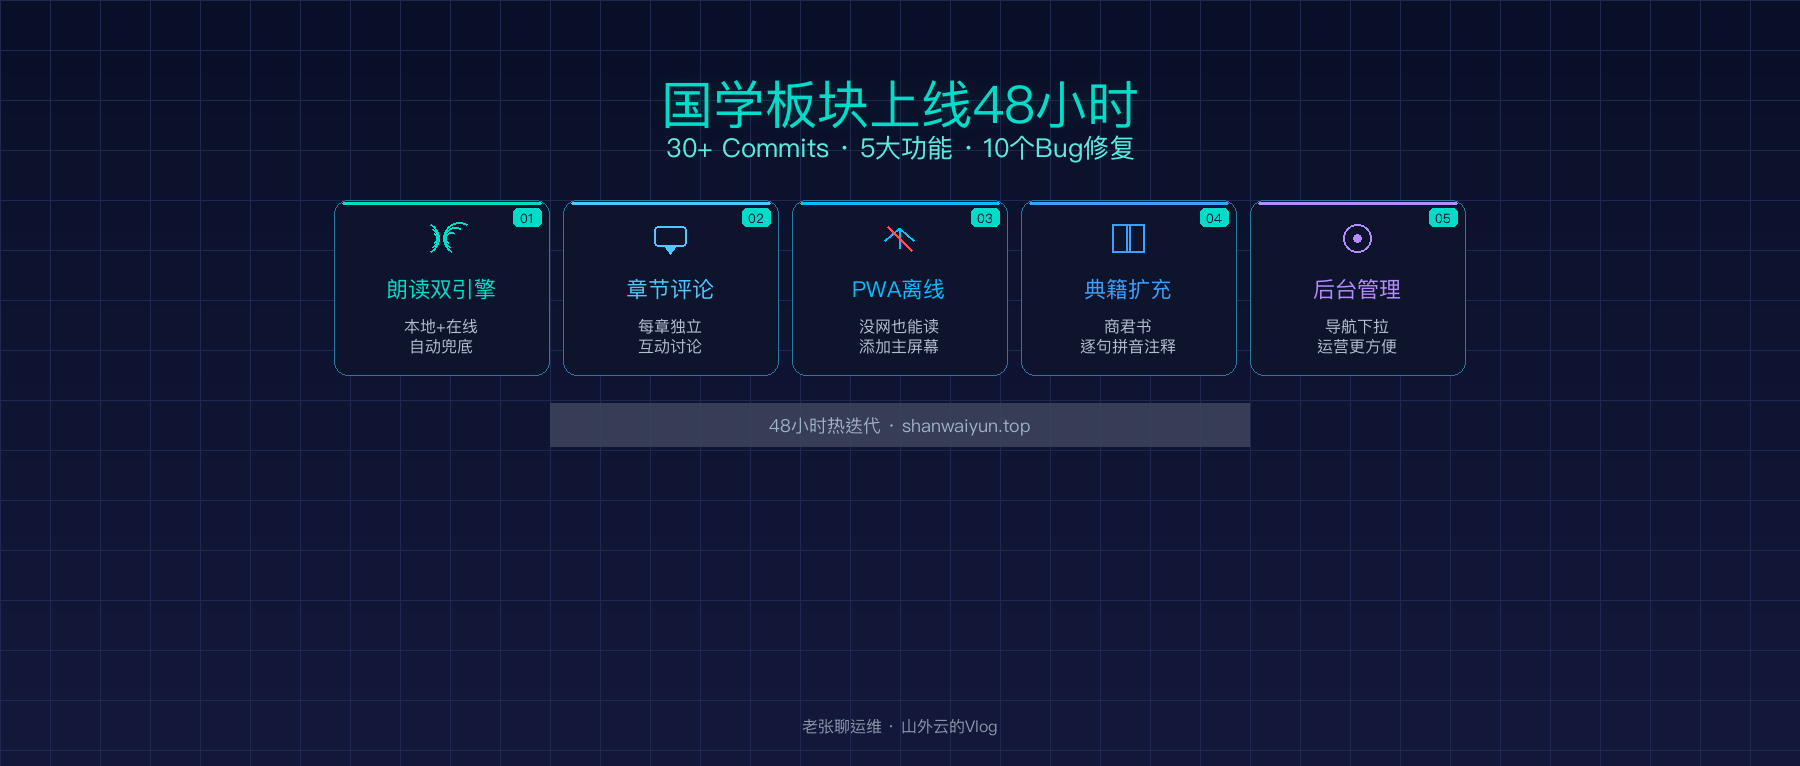
国学板块上线 48 小时,我修了 30 个 bug——最难的居然是朗读功能
大家好,我是老张。
前天写了篇文章,《我用 DeepSeek v4 Flash + Codex,10 小时写完博客国学板块》,发出去之后收到不少反馈。
有一条我印象特别深:
"朗读功能点了没声音啊,是不是还没做完?"
那一刻我才意识到一个残酷的事实:上线只是开始,真正的挑战是上线之后。
从文章发出到现在的 48 小时里,我又提交了 30 多个 commit。今天不讲 AI 怎么辅助开发了,就讲讲一个运维人是怎么在两天之内,把一个"能用"的产品迭代到"好用"的。
🎤 最大的坑:朗读功能,修了 10 个版本
Web Speech API 看起来很简单对吧?就几行代码:
const utterance = new SpeechSynthesisUtterance('道可道,非常道');
window.speechSynthesis.speak(utterance);
实际用起来,坑多得我怀疑人生。
坑 1:有人点朗读,真的没声音
第一个用户反馈就是"点了没反应"。排查发现 Android Chrome 有自动播放限制——浏览器不允许网页在用户没有交互的情况下自动发声。
修法:先播放一个静默 utterance 激活引擎,再开始朗读。
const activate = new SpeechSynthesisUtterance('');
activate.volume = 0;
window.speechSynthesis.speak(activate);
搞定了?这才刚开始。
坑 2:语音列表是异步加载的
window.speechSynthesis.getVoices() 在很多浏览器上第一次调用返回空数组。你以为语音引擎没准备好,其实它只是还没加载完。
修法:每次朗读前都检查,为空就延迟 100ms 重试。这个修法在前天的文章里写过——但后来发现还不够。
坑 3:有引擎、有事件、但就是没声音
这个坑真的把我整懵了。
Chrome 和 Edge 在某些机器上,getVoices() 返回了中文语音,speak() 触发了 start 事件,onend 也正常触发——但扬声器里一片寂静。
这就是"哑引擎"(Dumb Engine):所有状态都是正常的,但它就是不输出音频。
修法:加音频输出检测。如果引擎触发了 start 事件但在合理时间内没有实际音频输出,自动标记为哑引擎,切换到在线语音。
坑 4:在线语音也会失败
客户端不行,那我自己搭一个服务端 TTS。用了 edge-tts——微软 Edge 浏览器的文字转语音引擎,音质好、免费、不需要 API Key。
# 服务端:接收文本,返回 MP3 音频流
import edge_tts

async def synthesize(text, voice="zh-CN-XiaoxiaoNeural"):
    communicate = edge_tts.Communicate(text, voice)
    # 返回 Base64 编码的音频
客户端收到后,用 Web Audio API 播放:
const audioContext = new AudioContext();
const audioBuffer = await audioContext.decodeAudioData(arrayBuffer);
const source = audioContext.createBufferSource();
source.buffer = audioBuffer;
source.connect(audioContext.destination);
source.start();
但还是有坑:在线语音的连读问题。如果网络不稳定,上一句还没播完下一句就来了。修了 3 个版本才稳定。
坑 5:本地异常时的在线降级
最极端的情况:本地语音引擎抛了异常,同步报错,整个朗读流程断开。
修法:本地 + 在线双引擎兜底机制。本地是主力,在线是备胎。检测到本地引擎异常 → 自动切换在线语音 → 记住这个用户下次直接用在线。
坑 6:记得住的痛点——单句点读始终读第一句
用户点击第三句"故常无欲,以观其妙",朗读的永远是第一句"道可道,非常道"。
排查发现是状态管理问题:句子索引没有正确传递到朗读队列。修复后,点击任意一句都能正确朗读。
从"有时没声音"到"双引擎兜底,基本不出问题",10 个 commit,修了一天半。
💬 评论和互动,从零到完整
上一篇文章发出去的时候,国学板块是有评论功能的——但只是一个简单的文本框。
两天之内我把它迭代成了:
- 章节级隔离的评论区:每章有独立的讨论区,顶部显示"《道德经》第一章 · 本章讨论"。读完第一章的感悟不会和第二章混在一起
- 邮箱改为选填:之前的评论要求填邮箱,虽然做了 MX 校验,但很多人觉得麻烦。现在只要求昵称和评论内容,邮箱可填可不填
- 点赞、收藏、分享:每章底部加了完整的互动工具栏。不止国学板块有,文章页也统一加上了
// 互动工具栏:点赞→收藏→分享→评论,四合一
<ToolBar>
  <Button icon={<LikeOutlined />}>点赞</Button>
  <Button icon={<StarOutlined />}>收藏</Button>
  <Button icon={<ShareAltOutlined />}>分享</Button>
  <Button icon={<MessageOutlined />}>评论</Button>
</ToolBar>
📱 PWA 全站离线,没网也能读
这个功能是深夜加的——突然想到,如果有人在通勤的地铁上想读道德经,没信号怎么办?
PWA(Progressive Web App)方案:用 Service Worker 缓存全站资源,离线也能访问。
// service-worker.js
self.addEventListener('install', (event) => {
  event.waitUntil(
    caches.open('shanwaiyun-v1').then((cache) => {
      return cache.addAll([
        '/',
        '/guoxue',
        '/guoxue/dao-de-jing',
        // ... 所有静态资源
      ]);
    })
  );
});
现在访问 shanwaiyun.top,浏览器会自动提示"添加到主屏幕",加完之后就是一个独立的 App——有图标、有启动画面、离线可用。
📚 典籍也在涨
从最开始的《道德经》单部,到现在:
- 道家:道德经(81 章)、庄子(33 章,已经上线)、列子(即将上线)
- 儒家:论语、孟子、大学、中庸
- 法家:商君书(已上线,逐句拼音+译文+注释完整)、韩非子
- 兵家:孙子兵法
- 纵横家:鬼谷子
商君书是昨天刚补齐的——26 章,逐句标注拼音,逐章配上译文和字词注释。后台管理模块也做好了,后续加新书不用改代码,后台直接录入。
🎨 还有这些细节
- 顶部导航改版:三个主要菜单支持下拉,不用每次都跳转
- 侧边栏分类优化:从简单的文字列表改成了带图标的卡片展示,故障案例和 AI 工具展示子分类
- 后台编辑器换了 MDXEditor:所见即所得,写文章效率提升不少
- 公众号排版主题:后台编辑器可以直接预览公众号排版效果
- 访问日志记录:国学阅读页加了埋点,知道哪些典籍读的人多
📊 48 小时迭代数据
| 指标 | 数据 |
|---|---|
| 新增 commit | 30+ |
| 新增功能 | 5 个大功能 |
| 修复 bug | 10+ |
| TTS 相关 commit | 10 |
| 新上线典籍 | 商君书 |
| 最大的坑 | 哑引擎检测 |
🧠 几点感悟
1. 上线不是终点,反馈才是起点
如果我没发那篇文章,就没人告诉我"朗读没声音"。我可能一直以为朗读功能是好的。
做产品,最值钱的不是你的代码,是用户反馈。
2. 看起来简单的功能,可能是最大的坑
TTS 朗读,就几行 Web Speech API 代码。结果修了 10 个版本,从本地到在线到双引擎兜底。
你永远不知道哪个"简单功能"会成为你的时间黑洞。
3. 一个人 + AI,48 小时能干很多事
30 个 commit、5 个大功能、10 个 bug 修复,按传统开发节奏,这可能需要一个 3 人团队干一周。但有了 AI 辅助,一个人两天就能搞定。
不是说我能力强,是工具变了。
🔗 来试试?
如果你还没看过国学板块,现在是个好时机:
👉 shanwaiyun.top/guoxue/dao-de-jing
- 打开就能读,拼音直接标在字上面
- 点击任意句子可以朗读
- 81 章侧边栏随便跳
- 全书检索,搜"无为"直接定位
- 没网也能用(PWA 离线)
如果你试了之后有什么想法——朗读还是没声音?某个字的拼音标错了?想要更多典籍?评论区告诉我。
山外云的Vlog | shanwaiyun.top
关注我,分享编程、运维、AI 工具实战,以及有意思的技术探索。